지역 성장의 불균등한 고용효과: 기초자치단체 지역 노동시장의 공간 패널분석
 ; 김의준***
; Kim, Euijune***
Abstract
This study examines how the employment effects of regional growth differ across structurally distinct local labor markets in Korea, using a spatially augmented employment elasticity framework. Drawing on panel data from Korea's 229 lower-tier local governments, we classify regions into four clusters (large-scale core economy, high-density service, small-scale peripheral, and manufacturing industrial) via ex ante principal component analysis and K-means clustering. We then decompose direct and indirect employment effects through marginal-effects analysis based on a dynamic spatial Durbin model (SDM), combined with pairwise cluster comparisons. Results show that the direct employment response to own-region GRDP growth operates universally across clusters, with no statistically significant pairwise differences. In contrast, the transmission of growth spillovers to neighboring regions is markedly asymmetric across clusters. Notably, the large-scale core economy cluster generates approximately 87% of its long-run total effect through cross-regional spillovers, while other clusters exhibit weak or statistically insignificant spillover transmission. These findings suggest that Korea's regional labor market policy design should adopt a dual structure combining a common axis of strengthening own-region growth-employment linkage with a differentiated axis calibrated to cluster-specific spillover transmission capacity.
Keywords:
Employment Elasticity, Regional Labor Market, Cluster-specific Spillover, Dynamic SDM, Ex Ante Clustering키워드:
고용탄력성, 지역 노동시장, 군집별 광역 파급, 동적 공간 더빈모형, 사전적 군집화Ⅰ. 서 론
한국 노동시장에서는 거시 차원에서 성장의 고용 흡수 능력이 약화되는 가운데, 지역 차원에서 인구·고용·산업 격차가 누적되는 양상이 관측되어 왔다. 산업구조 전환과 자본 집약도 상승, 인구 구조 변화 등 거시적 요인이 성장과 고용의 전이를 약화시키는 동시에, 수도권으로의 산업·인구 집중과 비수도권 일부 지역의 인구 감소·산업 기반 위축이 함께 진행되어 왔다. 두 현상은 서로 다른 차원의 문제로 보이지만 결국 한 가지 질문으로 수렴한다. 동일한 거시 환경에 놓인 지역들 사이에서 성장의 고용 반응이 어떻게 분화되는가이다. 거시 단위에 토대를 둔 성장과 고용 연계의 고전적 명제(Okun, 1963)는 시기별 평균을 추적하는 데는 적합하지만, 동일 시기 안에서의 지역 간 구조적 분화는 거시 평균 안에 가려져 식별되지 않는다. 이 분화를 식별하기 위해서는 분석의 시선이 거시에서 지역으로, 그리고 광역에서 기초자치단체 차원으로 이동해야 한다.
본 연구의 목적은 한국 지역 노동시장에서 성장의 고용 파급효과가 지역의 구조적 특성에 따라 어떻게 분화되는지를 공간을 고려한 고용탄력성 분석틀에서 규명하는 데 있다. 구체적으로, 자기 지역 성장이 자기 지역의 고용을 흡수하는 직접적 메커니즘과 광역 차원으로 파급되는 간접적 메커니즘이 지역 유형에 따라 어떻게 차별화되는지를 식별하고, 이를 통해 한국 지역 노동시장의 구조적 분화가 어떤 차원에서 발현되고 있는지를 실증적으로 규명하고자 한다. 이를 위해 본 연구는 한국 229개 기초자치단체를 분석 단위로 채택하고, 사전적 군집화를 통해 동질적 지역 그룹의 경계를 외생적으로 결정한 후, 각 군집 안에서 직접 효과와 간접 효과를 분리하여 추정한다. 분석 단위의 세밀화는 광역 평균 안에 가려진 시·군·구 차원의 분화를 드러내고, 사전 군집화는 군집의 정의와 효과 추정의 단계를 분리하며, 직접·간접 효과의 분리 추정은 인접 자치단체와의 공간적 의존성이 지역마다 비대칭적으로 작동하는지를 검증하기 위함이다.
본 연구는 위 목적을 다음 세 가지 질문으로 구체화한다. 첫째, 자기 지역 성장의 직접적 고용 흡수는 지역의 구조적 유형에 따라 분화되는가, 아니면 군집과 무관하게 보편적으로 작동하는가? 둘째, 자기 지역 성장의 간접적 광역 파급은 지역의 구조적 유형에 따라 어떻게 비대칭적으로 나타나는가? 셋째, 직접 효과와 간접 효과의 분화 양상은 한국 지역 노동시장의 구조적 분화가 어느 차원에서 발현되고 있는지를 보여주는가? 첫째와 둘째 질문이 효과 추정 차원의 식별 작업이라면, 셋째 질문은 그 식별 결과를 한국 지역 노동시장의 구조적 분화 발현 지점에 대한 통합 평가로 이어가는 작업이며, 본 연구의 핵심 관심사가 놓인 지점이다.
본 연구의 기여는 한국 지역 노동시장의 구조적 분화가 직접적 고용 흡수 능력의 차이에서 발현되는지, 아니면 광역 파급의 비대칭에서 발현되는지를 군집별 식별을 통해 검증한다는 데 있다. 분석 결과는 직접 효과의 보편적 안정성과 간접 효과의 군집별 분화를 보이며, 이를 통해 본 연구는 그동안 평균 차원의 단일 추정에 가려져 있던 분화의 발현 지점을 한국 지역 노동시장의 자료에서 실증한다. 이러한 검증을 가능케 하는 방법론적 도구로서, 본 연구는 사전적 PCA·K-means 군집화, 동적 공간 더빈 모형(SDM), 그리고 군집별 한계효과 분해의 결합을 단일 분석 틀 안에 통합한다. 이러한 결합을 통해 광역시도 평균에 가려진 시·군·구 단위 이질성과 군집별 광역 파급 비대칭이 정량적으로 포착된다. 본 연구의 정체성은 이러한 방법론적 결합 그 자체가 아니라, 그 결합이 가능케 하는 해석에 있다.
Ⅱ. 선행연구 고찰
성장과 고용의 거시적 연계는 실질 산출량과 실업률 사이의 안정적 역관계가 실증된 이래 거시경제학의 핵심 명제로 자리해 왔다(Okun, 1963). 한국에서도 산출량 1% 증가가 실업률을 약 0.3~0.4%p 감소시키는 강한 관계가 확인되어 왔으나(Woo, 2023), 한국 오쿤 계수의 절댓값은 2000년을 기점으로 절반 이하로 축소되었고(Woo, 2023), 글로벌 금융위기 전후로 GDP 변화에 대한 취업자 수 반응계수는 0.63에서 0.42로 유의하게 하락하는 비동조화 양상이 보고되었다(박세준 외, 2013). 국제 차원에서도 성장의 과실이 과거와 같이 고용으로 충분히 전이되지 않을 수 있다는 우려가 정책 의제로 부상해 있다(IMF, 2013). 다만 Okun(1963)이 다룬 명제는 경기변동에 따른 고용변동에 관한 거시 차원의 관계에 해당하여, 동일 시기 안에서 지역 간 고용 반응성의 구조적 분화를 식별하는 분석 목적과는 구별된다. 산출량 변화에 대한 고용 변화의 비율로 정의되는 고용탄력성 개념이 지역 단위 분석에서 점차 채택되어 온 것은 이러한 구별을 반영한다.
지역 노동시장의 이질성을 실증하기 위해서는 분석 단위의 선택이 결정적이다. 집계 단위에 따라 통계적 추정치에 체계적 편의가 발생할 수 있다는 임의적 지역 단위 문제(Modifiable Areal Unit Problem, MAUP)가 제기된 이래(Openshaw, 1984), 분석 단위가 추정 결과를 구조적으로 좌우할 수 있다는 점이 광범위하게 논의되어 왔다. 프랑스 근로자 패널 분석에서는 개인 고정 효과를 통제하지 않고 집계 자료만 사용할 경우 고용 밀도의 임금 탄력성이 약 두 배(0.0302에서 0.0562로) 과대추정되는 것이 확인되었으며(Combes et al., 2008; Combes and Gobillon, 2015), 64편의 인구·고용 인과 연구를 포괄한 메타분석은 분석 단위의 공간 해상도에 따라 결론이 역전될 수 있음을 보여준다(Hoogstra et al., 2017). 광역시도는 동일 권역 내부의 도심·외곽·산업집적지를 평균하여 시·군·구 사이의 구조적 격차를 광역 평균 안에서 상쇄시킬 위험을 내포한다.
지역 단위 분석을 채택한 해외 연구들은 일관되게 강력한 지역 간 이질성을 실증해 왔다. 핀란드 74개 통근권 패널에서 지역 오쿤 계수의 비대칭성이(Kangasharju et al., 2012), 스페인 17개 지역에서 -0.399에서 -1.069에 이르는 광범위한 분포가 식별되었고(Bande and Martín-Román, 2018), 미국에서는 부정적 고용 충격이 즉각 해소되지 않고 8~17년 후에도 그 효과의 15~25%가 잔존하는 영구 효과가 일관되게 보고되었다(Blanchard et al., 1992; Partridge et al., 2015). 이질성 식별은 점차 두 방향으로 정교화되어 왔는데, 지역을 사전 분류한 후 공간 패널 모형에 결합한 spatial regimes 접근(Cortinovis and Oort, 2015)과 비대칭 공간 가중 행렬을 동적 패널에 결합한 접근(Krause and Kripfganz, 2025)이 그것이다. 전자에서는 다양성 변수의 효과가 체제별로 부호와 유의성이 달라지는 분화 패턴이 식별되었고, 후자에서는 부유한 20개 카운티에 가해진 충격이 미처리 지역으로 파급되는 비대칭 중심·주변부 효과가 통근 흐름 행렬에서만 식별되었다.
한국의 고용탄력성 실증은 국가 단위 분석에서 시작하여(김용현, 2005), 이후 광역시도 단위의 광역권 수준에 일관되게 집중되어 왔으며(심재훈, 2008; Choi and Kim, 2017; 이연호·이창민, 2020; Park and Kim, 2025), 회복력 분석(Kim and Hong, 2019) 또한 광역 단위에 한정되고 산업 단위 패널 분석(정현준 외, 2023)에서도 지역 차원의 구조적 이질성은 식별되지 않는다. 광역권 분석 단위는 권역 내부의 도심·외곽·산업집적지 사이의 구조적 격차를 평균화하며, 비공간 패널 모형의 채택은 광역 파급의 비대칭을 모형 차원에서 식별 불가능하게 만든다. 한국에서 시·군·구 단위 자료는 회복력(Yu and Kim, 2021), 청년 직업인구이동(손경현·김의준, 2025), 도(道) 단위 시·군 패널의 동적 GMM 추정(구재운 외, 2021) 등 인접 분야에 한정 활용되어 왔다.
지역 간 차별화 패턴의 이론적 토대는 세 가지 메커니즘으로 정리되어 왔다. 도시 집적경제의 미시적 기초는 공유, 매칭, 학습으로 체계화되어 왔으며, 이들 메커니즘은 노동시장 규모가 클수록 1인당 생산성과 매칭 효율이 높아지는 방향으로 작동한다(Duranton and Puga, 2004). 이는 대규모 집적이 형성된 지역에서 행정경계를 넘어 작동하는 노동시장 거점 기능이 형성될 수 있음을 시사한다. 다른 한편 노동을 채용·해고·훈련의 고정 비용을 동반하는 준고정요소(quasi-fixed factor)로 본 이론은 단기 고용 탄력성을 1보다 작은 값으로 안정화시키는 노동저장(labor hoarding) 메커니즘의 토대로 평가되며(Oi, 1962; Biddle, 2014), 자본·생산성 집약도가 높은 지역에서 단기 고용 반응이 둔화될 가능성을 시사한다. 한국 거시 노동시장 모형 분석에서는 노동공급 측의 구조적 변화, 특히 생산가능인구 감소가 고용탄력성을 감소시키는 핵심 경로임이 확인되었다(최창곤, 2021).
지역의 구조적 이질성을 식별하기 위한 사전 단계로서 데이터 기반 유형화 방법론은 국내외에 다층적으로 축적되어 왔다. 지역 혁신 체제의 결함 유형을 분류하고 각 유형에 대응하는 차별화된 정책을 권고한 이론적 작업은 일률적 접근의 한계를 명시한 대표적 사례로 평가된다(Tödtling and Trippl, 2005). 한국에서는 전국 221개 시·군·구의 용도지역 자료(최호현·김선범, 2006), 수도권 66개 시·군·구의 도시 특성 자료(송민경·장훈, 2010), 229개 시·군·구의 체류인구 특성 자료(민보경·최지선, 2023)에 주성분분석과 군집분석을 결합한 분석이 축적되어 왔으며, 이들 연구는 사전적 행정구역에 의존하지 않고 다변량 자료에 내재된 구조적 유사성을 객관적 지표로 포착한다는 방법론적 공통점을 갖는다. 다만 한국의 데이터 기반 유형화는 도시계획·생활인구 등의 영역에 한정되어 축적되어 왔다.
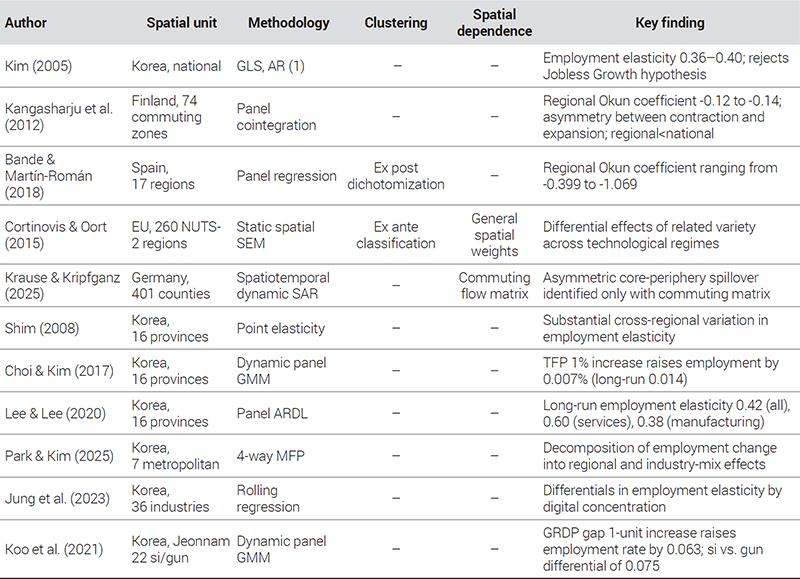
이상의 검토에서 한국 지역 노동시장의 성장과 고용 연계 연구에는 세 가지 공백이 누적되어 있다(Table 1). 첫째, 한국의 고용탄력성 실증은 광역시도 단위에 집중되어 시·군·구 차원의 구조적 이질성이 평균화 안에 가려져 왔다. 둘째, 해외에서는 사전 분류된 spatial regimes를 정태 공간 모형에 결합한 사례(Cortinovis and Oort, 2015)와 비대칭 통근 행렬을 동적 패널에 결합한 사례(Krause and Kripfganz, 2025)가 각각 등장했으나, 두 접근, 즉 사전 군집화와 동적 공간 더빈 모형(SDM)을 통합하여 군집별 광역 파급 비대칭을 식별한 연구는 보고되지 않았다. 셋째, 한국에서 시·군·구 단위 자료는 인접 분야에 한정 활용되어 왔으며, 사전 군집화와 동적 공간 패널 그리고 군집별 한계효과 분해를 결합하여 고용탄력성 영역에 적용한 사례는 부재하다. 본 연구는 229개 기초자치단체를 대상으로 사전적 군집화 위에서 공간 의존성을 반영한 분석을 수행함으로써, 지역 노동시장의 구조적 이질성을 직접적 고용 흡수와 광역 파급의 두 차원에서 종합적으로 식별한다. 이를 통해 그동안 평균 차원의 단일 추정에 가려져 있던 군집별 파급 비대칭이 시·군·구 차원에서 비로소 식별 가능해진다.

Comparative review of previous studies on regional employment elasticity and heterogeneity
Ⅲ. 연구방법론
1. 분석 자료
본 연구는 229개 기초자치단체(시·군·구)를 공간 단위로 2013~2021년의 패널 자료를 구축하였다. 분석의 시작 시점은 세종특별자치시 출범 이후 첫 완전 연도인 2013년으로 삼았으며, 상한은 활용 가능한 자료의 최신 연도인 2021년으로 설정하였다.1) 실질 GRDP는 2015년 기준 계열의 명목 GRDP에 GDP 디플레이터를 적용하여 산출하였으며, 인구 관련 변수는 행정안전부 주민등록인구 연앙통계, 사업체 및 고용 관련 변수는 국가데이터처 전국사업체조사의 마이크로 데이터를 기반으로 구축하였다.
본 연구의 분석 단위와 변수 정의의 공간적 일관성에 대해 명시할 필요가 있다. GRDP는 지역에서 발생한 경제활동의 부가가치 합계로, 본질적으로 사업체 기반(workplace-based) 측정값이다. 본 연구가 종속변수의 자료원으로 전국사업체조사를 채택한 것은 이러한 GRDP의 측정 정의와 일치하도록 사업체 기반의 고용 자료를 활용하기 위함이다. 즉 i 지역의 취업자는 i 지역 사업체에 종사하는 노동자로 정의되며, 두 변수가 동일한 공간 정의에 기반하여 측정되므로 추정된 고용탄력성은 i 지역에 입지한 사업체의 산출과 고용 간 반응을 직접 식별한다.
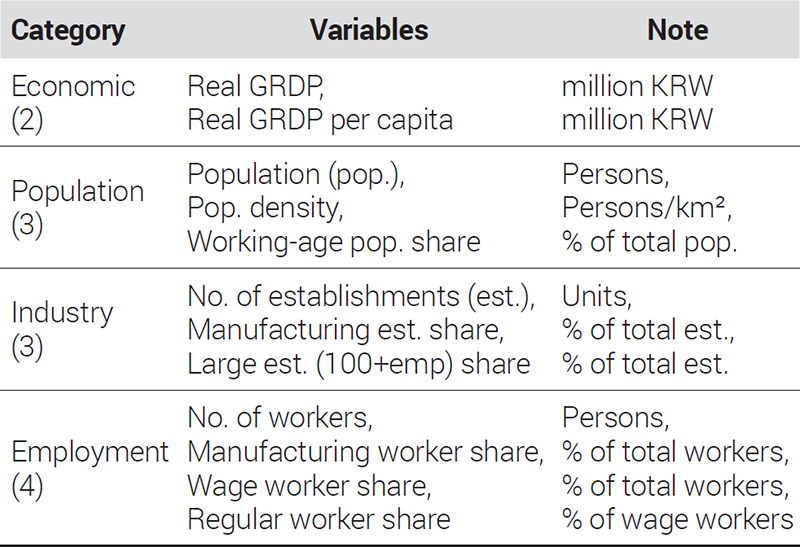
이와 같이 구축된 자료는 분석의 두 층위에 걸쳐 활용 기간과 변수 구성을 달리하여 사용된다. 지역 군집화(군집분석)에는 코로나19로 인한 외생적 충격을 배제하기 위해 2013~2019년 자료를 활용한다. 군집분석은 지역의 구조적 특성을 다차원적으로 포착하는 것이 목적이므로, 경제·인구·산업·고용 구조를 반영하는 12개 수준 변수를 포괄적으로 투입한다(Table 2).
Variables used in cluster analysis
이와 달리 고용탄력성 추정(패널회귀분석)에는 시계열을 최대한 확보하기 위해 2013~2021년 전체 패널 자료를 활용한다. 회귀분석의 통제변수는 GRDP 성장률과 고용 증가율 간의 관계를 교란하는 시변(time-varying) 요인만을 대상으로 하며, 군집 더미가 이미 지역의 구조적 이질성을 흡수하고 있어 추가적인 수준 변수의 포함은 불필요하다. 이에 따라 종속변수는 취업자 수 증가율, 핵심 독립변수는 실질 GRDP 성장률, 통제변수는 인구 증가율·사업체 수 증가율·제조업 입지계수 변화로 구성한다. 군집 분류는 군집분석 결과를 토대로 구성한 더미 변수로 도입된다.
2. 지역 군집화 방법론
지역 군집화는 주성분분석(PCA)과 K-means 군집분석을 순차적으로 적용하는 방식으로 수행하였다. 군집분석에 투입된 12개 수준 변수는 앞서 제시한 바와 같이 2013~2019년으로 한정한 기간의 지역별 산술평균으로 산출하였다. 이는 코로나19로 인한 외생적 충격을 배제함과 동시에 특정 연도의 일시적 교란을 평활화하여 각 지역의 내재적 구조 특성을 안정적으로 포착하기 위한 것이다. 여기에 더해, 군집 분류의 기반인 수준 변수를 회귀 모형의 성장률 변수와 개념적으로 분리함으로써 군집을 사전 결정된 처치 변수로 취급하는 것이 정당화되며, 이를 통해 잠재적 내생성 우려도 완화된다.
이를 위해 먼저 주성분분석(Principal Component Analysis, 이하 PCA)을 적용하였다. PCA는 서로 상관관계를 갖는 다수의 변수를 상관관계가 없는 소수의 주성분으로 변환하는 차원 축소 기법이다. 각 주성분은 원변수의 표준화값에 성분적재값(component loading)을 적용한 선형결합으로 정의된다(식 (1)).
| (1) |
zj는 j번째 표준화 변수, ωij는 i번째 주성분에 대한 j번째 변수의 성분적재값이다. 주성분은 원변수의 분산을 최대화하는 방향으로 순차적으로 추출되며, 주성분 간에는 상관관계가 존재하지 않는다. 본 연구에서는 성분적재값 자체보다 도출된 주성분 점수를 군집화의 입력 변수로 활용하는 데 초점을 둔다.
12개 변수를 직접 군집분석에 투입하면 차원의 저주(curse of dimensionality)로 인해 고차원 공간에서 관측치 간 거리 정보가 희석되어 군집 구조의 포착력이 저하될 우려가 있다. 또한 변수 간 상관이 높을 경우 특정 구조적 특성이 과대 반영될 수 있는데, 직교(orthogonal)하는 주성분 점수를 투입함으로써 이러한 문제를 동시에 방지할 수 있다. 분석에 앞서 12개 변수는 변수 간 측정 단위와 분산의 차이로 인해 특정 변수가 거리 계산을 지배하는 것을 방지하고자 표준화(z-score)를 적용하였다. 최적 주성분 수는 Kaiser(1960) 기준(고윳값≥1)에 따라 결정하였으며, 이와 같이 도출된 주성분 점수는 K-means 군집화의 입력 변수로 활용된다.
이와 같이 도출된 주성분 점수를 입력 변수로 하여 K-means 군집분석을 적용하였다. K-means는 사전에 지정된 k개의 군집 중심점과 각 관측치 간의 유클리드 거리를 기반으로 군집을 형성하는 분할형(partitional) 군집화 알고리즘이다. 임의의 k개 중심점을 선택한 후, 각 관측치를 가장 가까운 중심점의 군집에 할당하고, 군집 내 관측치의 평균으로 중심점을 갱신하는 과정을 중심점 변화가 없을 때까지 반복 수행한다. 이 알고리즘은 아래의 목적함수를 최소화하는 군집 배정을 탐색한다(식 (2)).
| (2) |
여기서 Ck는 군집 k에 속하는 관측치의 집합, μk는 군집 k의 중심점, ||∙|| 은 유클리드 거리이다. 연속형 변수로 구성된 다차원 자료에 적합하며, 사전적 행정구역 분류에 의존하지 않고 자료에 내재된 구조적 유사성을 객관적으로 포착할 수 있다는 점에서 본 연구의 분석 목적에 부합하는 방법론이다.
최적 군집 수는 Caliński and Harabasz(1974)의 CH 지수를 기준으로 결정하였다.2) 군집 개수(k)를 2부터 9까지 변화시키며, 각 k에 대해 서로 다른 초깃값을 사용한 500회 반복 추정을 수행하고 각 회차별 CH 지수를 산출하였다. 각 k에서 CH 지수가 최대인 초깃값을 해당 k의 대표 해로 채택한 후, k별 최대 CH 지수를 상호 비교하여 최적 군집 수를 결정하였다. 군집 분류의 통계적 타당성은 ANOVA 검정을 통해 추가로 확인하였다.
3. 고용탄력성 추정 모형
본 연구는 229개 기초자치단체의 2013~2021년 패널 자료를 활용해 고용탄력성을 추정한다. 한국 기초자치단체 단위에서 노동시장은 행정경계를 넘어 작동하며, 인근 지역 GRDP 성장의 파급(spillover)과 시차 종속변수의 자기상관이 비공간 모형의 추정 편의를 야기할 수 있다(Anselin, 1988). 이를 고려해 본 연구는 공간계량 모형을 도입하되, 비공간 모형인 고정효과 모형(Fixed Effects, FE)을 기준 모형으로 두고 단계적으로 확장하는 접근을 취한다.
임의효과(random effects)가 아닌 고정효과를 일관되게 채택한 근거는 두 가지이다. 첫째, 한국 229개 기초자치단체 자료에서는 시불변(time-invariant) 지역 특성이 본 연구의 주요 독립변수인 GRDP 성장률과 상관될 가능성이 높아, 임의효과 모형이 전제하는 직교성(orthogonality) 가정이 충족되기 어렵다. 반면 고정효과 추정량은 이 가정의 충족 여부와 무관하게 일치(consistency) 추정량을 산출한다. 둘째, 본 연구에 적용된 동적 공간 계량모형은 Yu et al.(2008)이 정립한 편향 보정 준최우추정(bias-corrected QMLE)에 따라 추정된다(Belotti et al., 2017). 이 추정 절차는 동적 패널의 incidental parameter problem(Neyman and Scott, 1948)으로 인한 시차 종속변수 계수의 편의(Nickell, 1981; Hsiao, 1986)를 공간 동적 패널 맥락으로 확장하여 보정한 것으로, 고정효과 모형에 한하여 정립되어 있다. 다만 고정효과의 적용은 자유도를 감소시킴과 동시에 시불변 군집 더미의 절대 효과를 직접 식별할 수 없게 한다는 제약이 발생한다. 이에, 본 연구는 군집 더미를 GRDP 성장률과의 상호작용항 및 선형결합 방식으로 도입하여 군집별 한계효과를 식별한다. 모형 선정 과정은 Elhorst(2014)가 권고한 일반화 모형 우선 전략(general-to-specific approach)에 따라 SAR(Spatial Autoregressive Model), SEM(Spatial Error Model), SDM(Spatial Durbin Model) 및 동적 SDM(dynamic SDM)을 단계적으로 추정한 후, 본 자료에 적합한 공간계량 모형을 z-검정 및 Wald 결합 검정으로 식별하였다.
한편, 종속변수와 독립변수는 모두 로그 차분값, 즉 전년 대비 증가율로 구성된다. 차분 변수의 사용은 단위근 검정으로 통계적으로 정당화된다. 로그화 취업자 수에 대한 단위근 검정 결과 단위근의 존재가 확인되었으며, 1차 차분 후에는 정상성이 확보되었다.3) 아울러 동일 지역 내 시계열 관측치 간 자기상관을 통제하기 위해 지역 단위 클러스터 표준오차를 사용하였다.
비공간 모형인 고정효과 모형은 식 (3)과 같다.
| (3) |
여기서 eit는 지역 i의 t기 취업자 수 증가율, git는 실질 GRDP 성장률을 나타낸다. 또한 Xit는 인구 증가율·사업체 수 증가율·제조업 입지계수(Location Quotient, LQ) 변화로 구성된 통제 변수 벡터로 종속변수 및 핵심 독립변수와 동일하게 전년 대비 변화량으로 투입된다. ηi는 지역 고정효과, μt는 연도 고정효과, ϵit는 오차항이다. 이 모형에서 계수(β)는 모든 지역에 공통으로 적용되는 평균 고용탄력성을 나타낸다. 지역 고정효과는 지리적 위치, 역사적 산업 기반 등 시불변(time-invariant) 지역 특성을 통제하며, 연도 고정효과는 경기 순환과 같이 모든 지역에 공통으로 작용하는 거시적 충격을 흡수한다.
이 기준 모형에 군집 더미와 GRDP 성장률의 상호작용항을 추가하여 군집별 고용탄력성의 이질성을 추정한다(식 (4)).
| (4) |
여기서 Dk는 군집 k에 속하는 지역을 나타내는 더미 변수이며, 기준 군집은 군집1이다.4) 상호작용항의 계수 γk는 기준 군집 대비 군집 k의 탄력성 차이를 포착한다. 각 군집의 탄력성 절대값은 선형결합(linear combination) 방식으로 개별 식별한다. 군집1의 탄력성은 β, 군집 k의 각 탄력성은 β + γk로 도출되며, 각각의 유의성은 분산-공분산 행렬을 활용하여 독립적으로 검정된다. 이는 상호작용항의 개별 유의성 검정이 기준 군집 대비 상대적 차이만을 검정하는 데 그치는 한계를 보완하여, 각 군집의 탄력성 자체를 독립적으로 식별할 수 있게 한다.
다음으로, 고정효과 모형(식 (4))을 일반화한 공간계량 모형으로 확장하면 식 (5)와 같다.
| (5) |
식 (5)는 본 연구가 추정하는 SAR·SDM 계열 모형을 포괄하는 일반 형태이며, 각 모형은 핵심 모수의 활성 여부에 따라 식별된다. SAR은 종속변수의 공간 자기회귀 ρ만 활성화된 모형이며, SEM은 오차항에 공간 자기상관 λ를 부여한 모형이다. SDM은 ρ와 인근 지역 독립변수의 공간 시차 θ가 함께 활성화되어 종속변수와 독립변수 양 측면에 공간 종속성을 부여한 모형이다. 이상의 정적 모형에 시차 종속변수의 자기회귀 τ를 추가한 형태가 동적 SAR과 동적 SDM이다. 본 연구에 적용한 이들 모형은 식 (5)에서 비활성 모수를 0으로 제약한 형태에 해당한다. δk는 군집별 파급(spillover)의 차이를, ΨW는 통제변수의 공간 시차 효과를 흡수한다. 본 연구의 주모형은 동적 SDM이며, 모형 선정의 정당성은 이후의 모형 식별 결과에서 확립된다.
공간 가중치 행렬은 두 가지를 적용한다. 주가중치 행렬 Wid55는 자치단체 중심점 간 inverse-distance에 55.6km 임계 거리(cutoff)를 적용한 후 행 표준화한 행렬로, 옹진군·울릉군을 제외한 모든 자치단체가 적어도 1개 이상의 인근 자치단체와 연결되는 임계 거리에서 산출된다. 강건성 점검용 WQ는 Queen contiguity 가중치 행렬에 일부 도서 지역의 공간적 고립(isolate)을 처리하기 위해 인접 자치단체와의 연결을 수동 보강한 후 행 표준화한 행렬이다.
SDM 추정 결과의 한계효과는 분해 정의에 따라 직접 효과(direct), 간접 효과(indirect), 총효과(total)로 분해된다(LeSage and Pace, 2009). 직접 효과는 자기 지역의 GRDP 성장이 자기 지역 고용에 미치는 반응(within-region)을, 간접 효과는 자기 지역 GRDP 성장이 인근 지역 고용에 미치는 파급 반응(across-region spillover)을, 총 효과는 두 효과의 합을 측정한다. 동적 SDM에서는 시차 자기회귀가 수렴된 정상 상태(steady-state)의 장기(LR, long-run) 효과와 t기 즉각 단기(SR, short-run) 효과를 별도로 식별한다. 군집별 한계효과는 β와 γk 등 추정된 모수의 비선형 함수로 도출되며, 표준오차는 LeSage and Pace(2009)의 시뮬레이션 방법으로 산출한다.
본 연구의 접근 방식은 Bande and Martín-Román(2018)의 방법론과 구별된다. 해당 연구가 탄력성 추정치를 기준으로 지역을 사후(ex post)적으로 이분화한 것과 달리, 본 연구는 경제·산업·인구·고용 관련 12개 변수에 기반한 사전(ex ante) 군집화를 적용함으로써 탄력성 이질성의 구조적 결정요인을 탄력성 추정과 독립된 단계에서 포착한다.
Ⅳ. 분석 결과
1. 지역 군집화
지역의 경제·산업·인구·고용 구조에 기반한 군집화 결과를 살펴보면 다음과 같다.
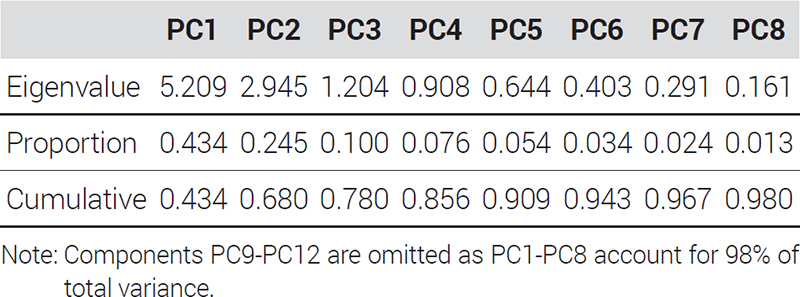
Kaiser(1960) 기준(고윳값≥1)에 따라 최적 주성분 수를 결정한 결과, 고윳값이 각각 5.209, 2.945, 1.204인 3개의 주성분이 선택되었다. 이들의 누적 설명력은 78.0%로, 원변수의 정보를 3개의 축으로 압축하면서도 군집화 투입 변수로서 충분한 설명력을 갖추고 있다고 판단하였다(Table 3).5)
Principal component analysis (PCA) results
도출된 3개의 주성분 점수를 입력 변수로 K-means 군집분석을 실시한 결과, 군집 개수가 4개일 때 CH 지수가 137.9로 최대치를 기록하여 이를 최적 군집 수로 확정하고, 해당 반복의 군집배정을 최종 결과로 채택하였다.6)
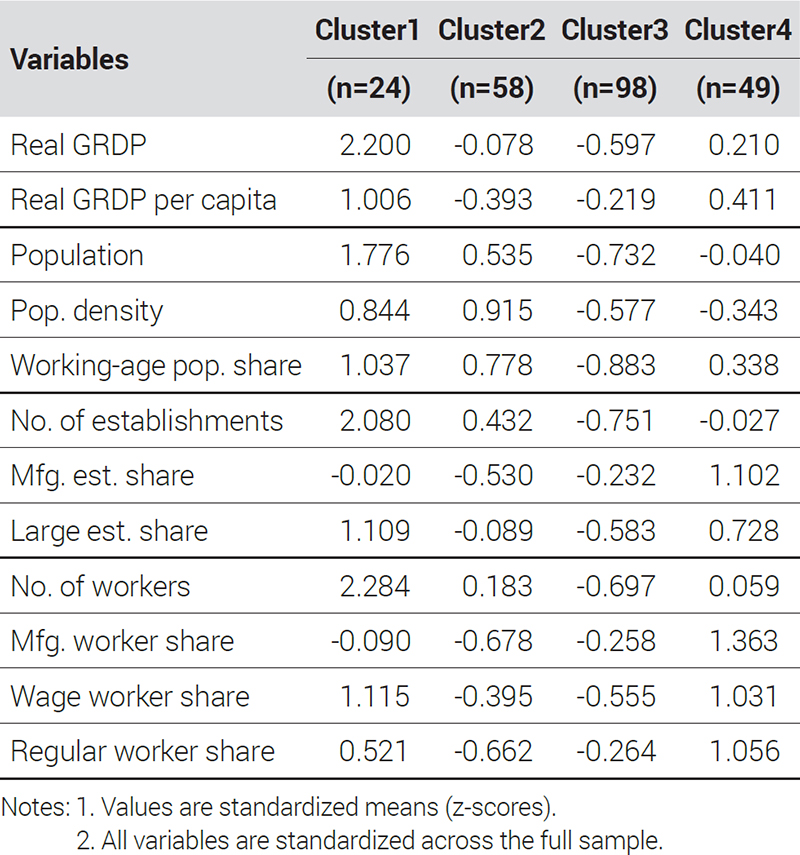
군집별 구조적 특성을 표준화 평균으로 살펴보면 다음과 같다(Table 4). 군집1은 GRDP, 취업자 수, 사업체 수, 인구 등 경제규모 관련 변수 전반에서 전국 평균을 크게 상회하며, 임금근로자 비중과 대규모 사업체 비중 또한 높다. 반면 제조업 사업체·취업자 비중은 전국 평균 수준에 머물러, 대규모 집적을 갖추되 제조업 특화 없이 서비스 중심의 핵심 경제권을 형성하고 있음을 확인할 수 있다. 이러한 구조적 특성에 근거하여 이 군집을 대규모 경제 핵심형으로 명명하였다.
Cluster characteristics: Standardized mean values
군집2는 인구밀도(0.915)와 생산가능인구 비중이 상대적으로 높은 반면, GRDP, 제조업 취업자 비중, 상용근로자 비중은 전국 평균을 하회한다. 인구 집중도는 높으나 경제 규모와 고용의 질적 수준이 동반되지 않는 이 구조는, 서비스업 중심의 도시 집적이 이루어졌으나 생산성과 고용 안정성이 제한된 고밀도 서비스형의 특징을 보여준다. 군집3은 GRDP, 인구, 생산가능인구 비중, 사업체 수, 취업자 수 등 거의 모든 변수에서 전국 최하위 수준을 기록한다. 특히 생산가능인구 비중의 표준화 평균이 -0.883으로 4개 군집 중 가장 낮아, 경제·인구 기반의 전반적 영세성과 구조적 노동공급 제약이 복합적으로 내재되어 있음을 보여준다. 이에 이 군집을 소규모 주변부형으로 명명하였다.
군집4는 제조업 취업자 비중(1.363)과 사업체 비중(1.102)이 4개 군집 중 압도적으로 높으며, 임금근로자 비중과 상용근로자 비중 또한 전국 평균을 상회한다. 인구밀도가 낮고 총 사업체·취업자 수가 평균 수준에 불과함에도 제조업 고용 특화 구조가 매우 선명하게 나타나는바, 제조업 중심의 산업·고용 집중을 이 군집의 지배적 특성으로 규정하고 제조업 산업형으로 명명하였다.
군집의 공간적 분포를 살펴보면, 군집1은 특별시·광역시의 핵심 자치구 및 대도시 인접 지역에 집중 분포하며, 군집2는 수도권 외곽 및 지방 중소도시에 광범위하게 나타난다. 군집3은 비수도권 농어촌 지역 전반에 폭넓게 분포하고, 군집4는 충청·영남 내륙 및 동남권 산업벨트를 중심으로 집적하는 양상을 보인다. PCA 산점도에서는 PC1-PC2 평면상에서 군집 간 분리가 시각적으로 확인되며, 군집1의 PC1 고점 집중과 군집3의 PC1 저점 분포가 뚜렷하게 대비된다. 군집2와 군집4는 PC2 축을 기준으로 각각 서비스화 방향과 제조업화 방향에 배치되는 대칭적 구조를 보인다(Figure 1).
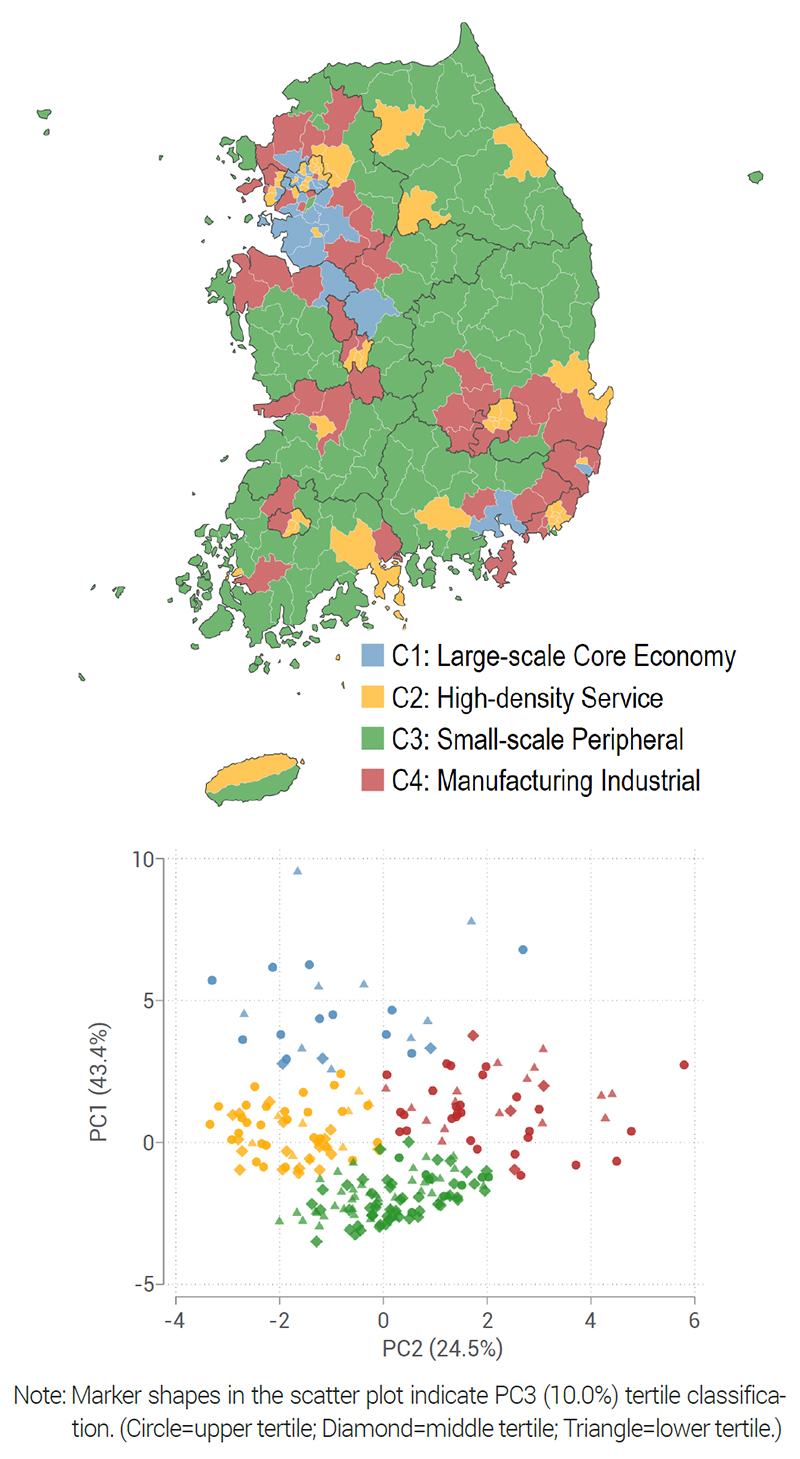
Regional distribution by cluster type: Administrative map and PCA scatter plot
아울러 군집 분류의 통계적 타당성을 확인하기 위해 ANOVA 검정을 실시한 결과, 12개 변수 모두에서 군집 간 평균 차이가 통계적으로 유의한 것으로 나타났다.7) CH 지수 기준의 최적 군집 수 선정, 군집별 표준화 평균의 구조적 차별성, 그리고 ANOVA에 의한 통계적 유의성 확인이 상호 정합적으로 수렴함으로써, 군집 분류의 타당성은 다층적으로 뒷받침된다. 이상의 군집화 결과를 바탕으로, 이하에서는 4개 군집을 단위로 고용탄력성의 이질적 패턴을 추정·분석한다.
2. 지역 군집별 고용탄력성 추정과 공간 분석
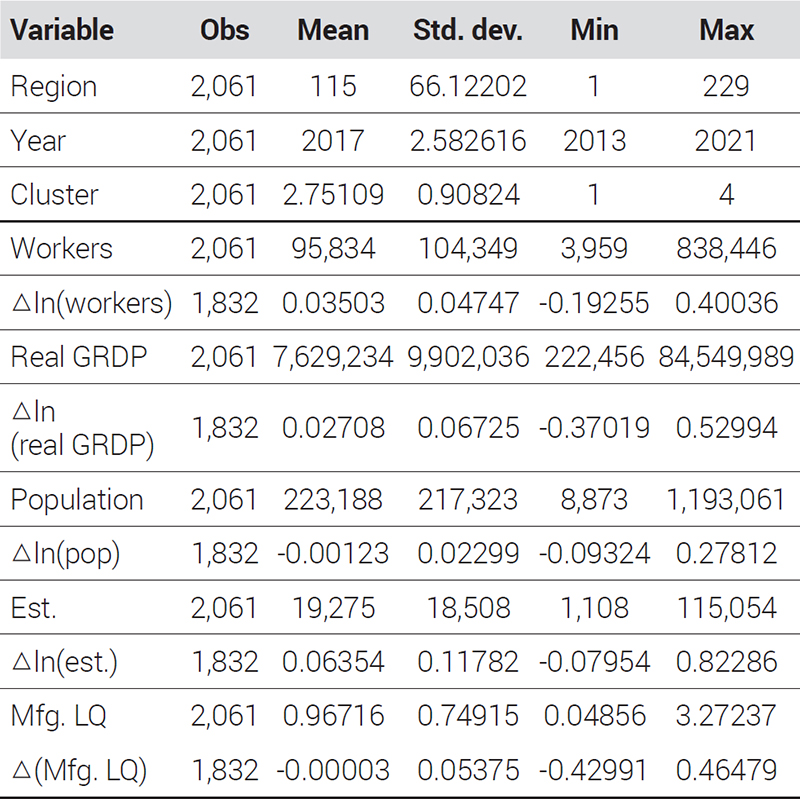
앞서 도출된 군집 유형을 토대로 지역 군집별 고용탄력성을 추정하였다. 추정결과를 보고하기에 앞서 분석에 사용된 패널 자료의 기초통계를 먼저 살펴본다(Table 5).
Descriptive statistics
차분 후 관측치는 229개 지역과 8개 연도를 곱한 1,832개이다. 취업자 수와 실질 GRDP의 표준편차가 모두 평균을 상회하여 229개 기초자치단체 간 경제 규모의 구조적 이질성이 확인되며, 이는 지역 유형별 분석의 필요성을 뒷받침한다. 인구 증가율의 평균이 -0.001로 음의 값을 보여 분석 기간 중 기초자치단체 전반의 인구 감소가 진행 중이었음이 확인된다. 한편 사업체 수 증가율의 평균(0.064)이 취업자 수 증가율(0.035)의 약 1.8배에 달해, 사업체 생태계의 확장이 반드시 고용 증가로 직결되지 않는 성장과 고용 간 구조적 괴리가 시사된다.
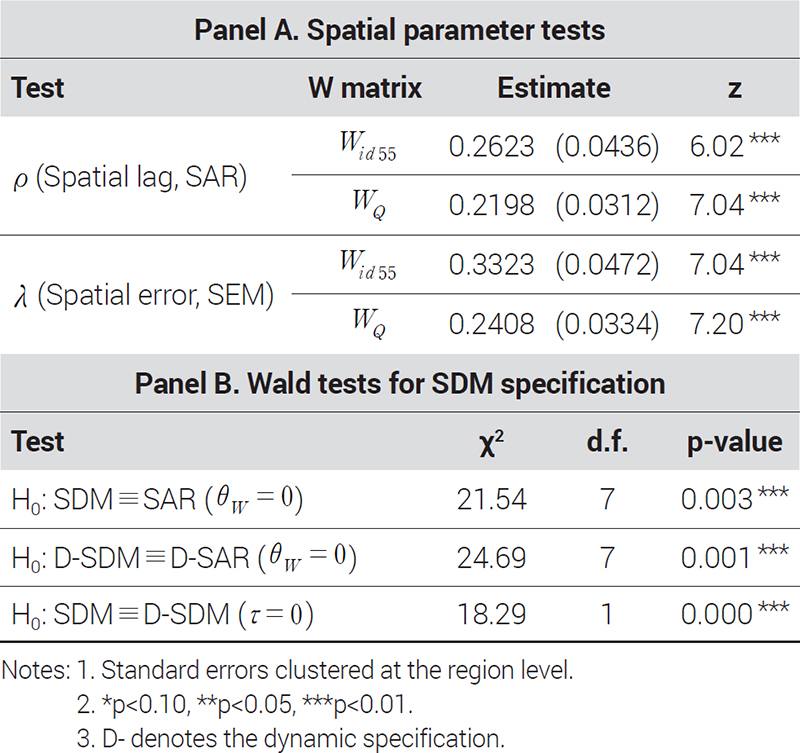
기초자치단체 단위에서 노동시장이 행정경계를 넘어 작동하며 인근 지역 GRDP 성장의 공간적 파급(spillover)이 작동한다는 이론적 논거는, 본 자료에서 통계적으로 검증되어야 추정 결과의 정당성을 담보할 수 있다. 이에 공간계량 모형의 식별 결과를 <Table 6>에 제시한다.
Spatial specification diagnostics
Panel A를 보면 SAR과 SEM 모두에서 공간 자기회귀 계수(ρ)와 공간 오차 자기상관 계수(λ)가 1% 수준에서 유의하여, 본 자료에 종속변수 차원과 오차항 차원의 공간 의존성이 동시에 존재함이 확인된다. 강건성 점검용 퀸 가중행렬(WQ)에서도 같은 결론이 도출된다. Panel B는 Wald 결합 검정에 따른 모형 식별 결과이다. SDM이 SAR로 축약된다는 귀무가설이 기각되어(p=0.003), SAR 대신 SDM 채택이 정당화된다. 동적 SDM에서도 같은 검정이 기각되며(p=0.001), 시차 종속변수 계수(τ)의 귀무가설도 기각되어(p<0.001) SDM 대신 동적 SDM 채택이 정당화된다. 이상의 단계적 진단을 종합하여 동적 SDM을 주모형으로 채택하며, 이하 추정 결과의 해석은 이 적절성 진단을 전제로 진행된다.
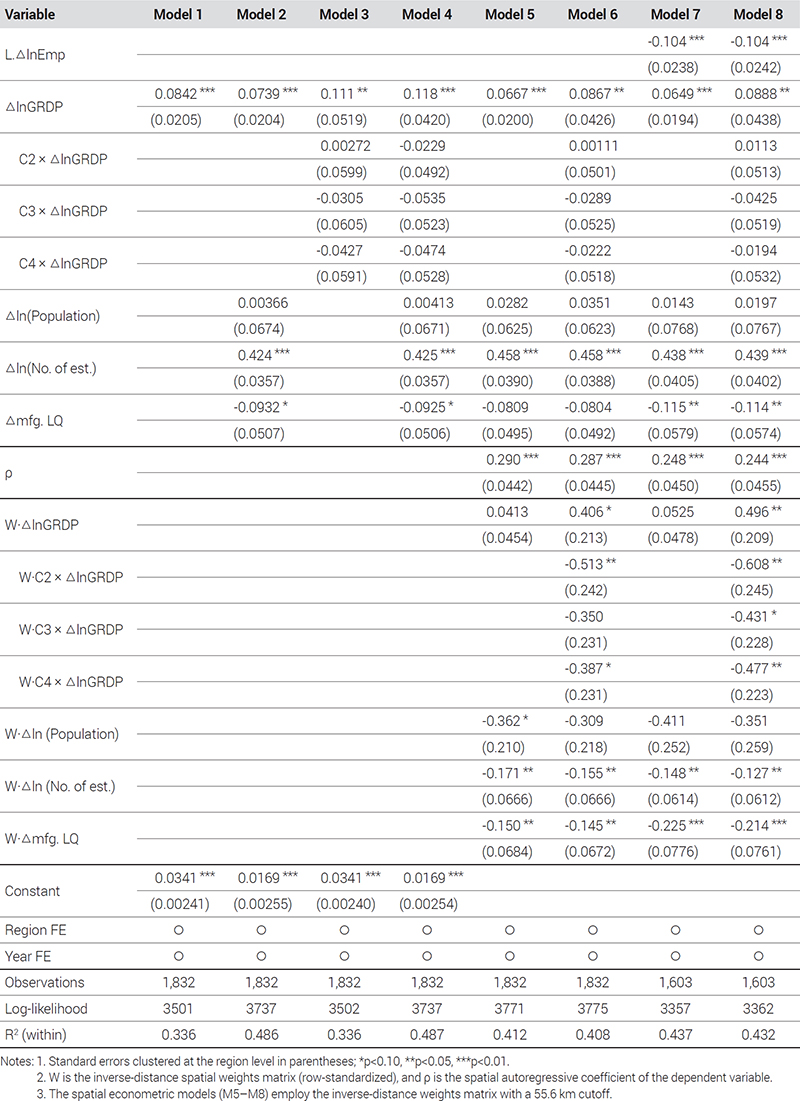
<Table 7>은 고정효과 모형(Model 1~4)과 공간계량 모형(Model 5~8)의 고용탄력성 추정 결과를 통합 보고한다.
Employment elasticity estimation results
고정효과 기준 모형(Model 1, Model 2)에서 GRDP 성장에 대한 고용탄력성은 각각 0.0842와 0.0739로 1% 수준에서 유의하게 추정된다. 이 추정치는 국가 단위(김용현, 2005: 0.36~0.40) 및 광역 단위 선행연구의 탄력성(이연호·이창민, 2020: 0.42) 대비 낮은 수준이다. 이는 MAUP 스케일 효과로 인한 국가·광역 단위의 집계 편의(Openshaw, 1984)가 기초자치단체 단위에서는 제거된 결과인 동시에, 소규모 개방경제 특성상 성장의 편익이 인접 지역으로 누출되는 공간적 파급이 작용한 결과로 이해된다(Blanchard et al., 1992; Kangasharju et al., 2012). Model 3과 Model 4의 군집 상호작용항은 모두 통계적으로 유의하지 않은데, 이는 기준 군집 대비 상대적 차이가 식별되지 않음을 의미할 뿐 군집별 동질성을 입증하는 근거로 해석할 수 없다. 군집별 차이의 본격적 식별은 동적 SDM 기반의 한계효과 분해와 쌍별 검정에서 이루어진다.
공간계량 모형의 결과는 고정효과 모형과 일관된 방향성을 유지하면서 공간 의존성을 명시적으로 통제한다. SDM 단일 모형(Model 5)에서 GRDP 변화가 고용 변화에 미치는 영향(β)은 0.067(p<0.01)로 나타나고, 공간 자기회귀 계수(ρ)는 0.290 (p<0.01)으로 유의미하게 식별된다. 본 지역 효과가 Model 2의 0.0739 대비 다소 축소된 것은 고정효과 모형이 본 지역 효과로 흡수하던 공간적 파급이 ρ 항으로 분리되었음을 의미한다. 동적 SDM 단일 모형(Model 7)에서는 시차 종속변수 계수(τ)가 -0.104로 유의하여(p<0.01) 본 자료의 동적 구조가 통계적으로 명확히 존재함이 입증된다. 통제변수의 효과는 모든 모형에서 일관되게 나타난다. 사업체 수 증가율의 계수는 0.43 내외로 1% 수준에서 유의하여 지역 고용의 직접적 원천이 사업체 생태계의 확장에 있음을 시사한다. 제조업 입지계수 변화는 음의 효과를 보여 제조업 특화 지역의 노동저장(labor hoarding) 행태와 정합한다. 한편, 본 모형의 진정한 의미는 추정치의 유의성보다 군집별 한계효과 분해를 통한 광역 파급의 비대칭 식별에 있으며, 이는 다음 단락에서 본격 분석된다.8)
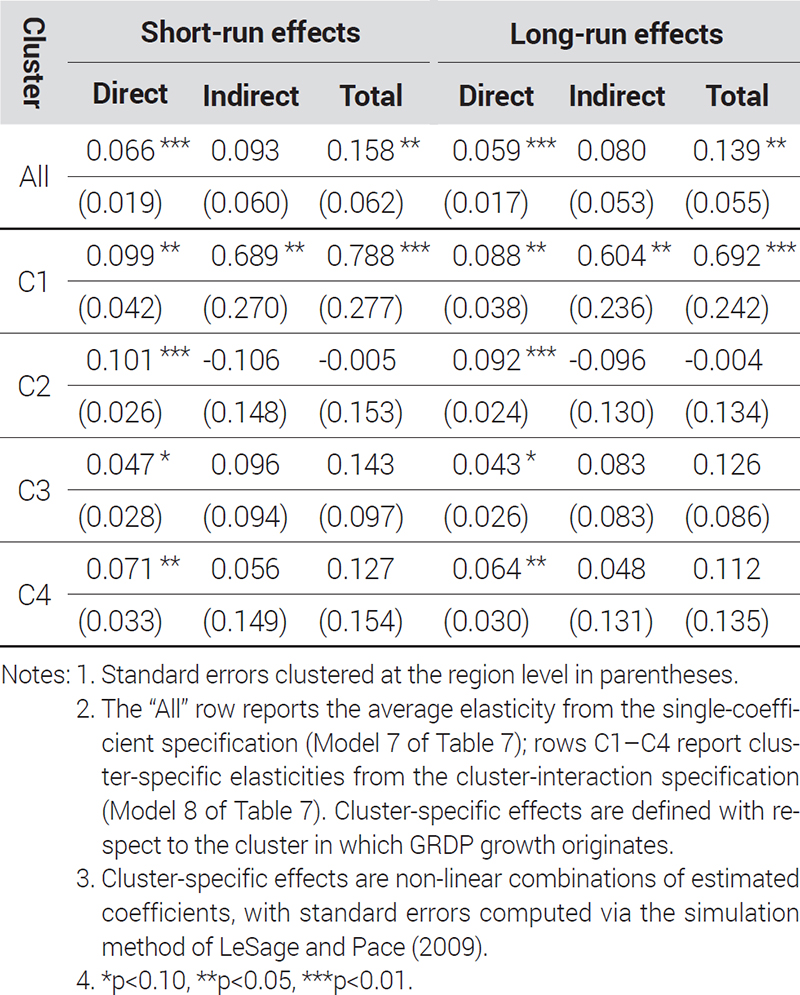
<Table 8>은 동적 SDM의 한계효과를 직간접 효과 분해 정의에 따라 그 결과를 보고한다(LeSage and Pace, 2009). 직접 효과는 자기 지역 내 GRDP 성장의 고용 반응을, 간접 효과는 자기 지역 GRDP 성장이 인근 지역 고용에 미치는 공간적 파급을, 총 효과는 두 효과의 합을 측정한다. 군집별 효과는 성장이 발생한 지역의 군집 유형을 기준으로 식별된다. 또한 단기 효과는 t기 즉각 반응을, 장기 효과는 시차 자기회귀가 수렴된 정상 상태의 누적 반응을 식별한다.
Marginal effects decomposition: Dynamic SDM
전체 표본의 단일 추정치(Model 7 기반)를 보면, 단기 총 효과 0.158과 장기 총 효과 0.139가 모두 5% 수준에서 유의하다. 그러나 이를 분해하면 직접 효과는 단기 0.066과 장기 0.059가 1% 수준에서 유의한 반면, 간접 효과는 단기와 장기 모두 통계적으로 유의하지 않다. 평균 차원에서 본 자료의 공간적 파급은 통계적으로 식별되지 않는 셈이다.
군집별 분해(Model 8 기반) 결과는 평균의 함의를 근본적으로 재해석하게 한다. 대규모 경제 핵심형(C1)에서 장기 간접 효과가 0.604(p<0.05), 장기 총 효과가 0.692(p<0.01)로 식별되며, 총 효과의 약 87%가 광역 spillover에서 발생하는 비대칭 구조가 확인된다. 이는 C1의 GRDP 성장이 인근 지역 고용으로 파급되는 차별적 구조가 통계적으로 식별됨을 의미한다. 반면 다른 모든 군집에서 장기 간접 효과는 통계적으로 유의하지 않으며, 단기 효과에서도 동일 패턴이 확인되어 C1의 차별성은 단기와 장기 모두에서 견고하다. 한편 4개 군집의 직접 효과는 그 격차가 미미하여, 군집 간 차별화의 원천이 자기 지역 직접 반응이 아닌 광역 spillover 역량의 차이에 있음을 시사한다. 고정효과 모형에서 군집 상호작용항이 유의하지 않았던 결과는 사실상 광역 spillover의 군집별 비대칭이 자기 지역 효과로 압축되어 나타난 결과임이 군집 분해를 통해 식별된다.
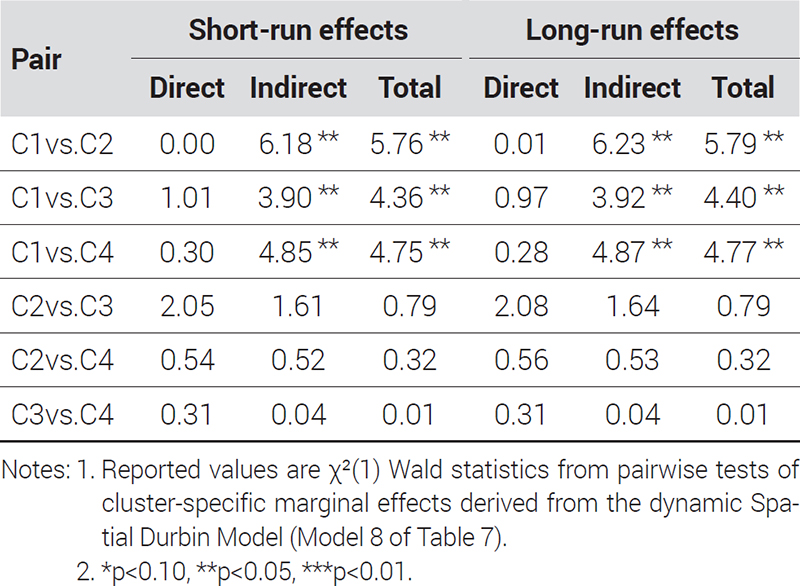
<Table 8>에서 관찰된 비대칭의 통계적 유의성은 <Table 9>의 6개 군집 쌍에 대한 Wald 검정에서 검증된다. C1과 다른 모든 군집 사이의 쌍에서 장기 간접 효과와 장기 총 효과가 모두 5% 수준에서 차별화되며, 단기 효과에서도 동일 패턴이 견고하게 유지된다. 이는 C1의 차별적 spillover가 단순한 점추정치 차이가 아닌 통계적으로 차별화된 군집 특성임을 의미한다.
Wald tests of cluster-specific marginal effects
직접 효과의 군집간 차이는 모든 쌍에서 통계적으로 유의하지 않으며, C2와 C3, C4 상호 간의 차이도 단기와 장기 모든 차원에서 유의하지 않다. 본 연구 결과가 나타내는 본질적 군집 동학은 C1이 다른 모든 군집과 통계적으로 강하게 구별되는 비대칭 구조이며, C1의 차별적 spillover는 단기와 장기, 간접 효과와 총 효과의 모든 차원에서 견고하게 입증된다.
Ⅴ. 결론 및 시사점
지역 단위 고용탄력성의 이질성은 다수의 선행연구에서 논의되어 왔으나, 한국의 전국 229개 기초자치단체를 전수 포괄하면서 사전적 군집화와 동적 공간계량 모형을 결합하여 군집별 광역 파급(spillover) 양상을 식별한 분석 틀은 이전까지 제시된 바 없었다. 본 연구는 경제·산업·인구·고용 구조를 반영한 다변량 지표로부터 4개 군집(C1: 대규모 경제 핵심형, C2: 고밀도 서비스형, C3: 소규모 주변부형, C4: 제조업 산업형)을 도출하고, 동적 SDM 기반의 한계효과 분해와 군집 쌍별 검정을 결합하여 군집별 고용탄력성 차별화의 본질을 식별하였다. 분석 결과의 핵심은 한 문장으로 요약된다. 자기 지역 GRDP 성장의 직접 고용 효과는 군집 유형과 무관하게 보편적으로 작동하나, 인근 지역으로의 광역 파급은 군집별로 비대칭적으로 분화된다. 이 한 문장이 한국 지역 노동시장의 본질적 모습을 요약하며, 다음 네 가지 측면에서 구체화된다.
첫째, 자기 지역 GRDP 성장과 고용 간의 직접 연계는 4개 군집 모두에서 통계적으로 유의하게 식별되며, 군집 간 직접 효과의 차이는 모든 쌍별 검정에서 유의하지 않다. 즉 자기 지역 직접 메커니즘은 군집 유형과 무관하게 보편적으로 작동한다. 이는 광역 파급이 식별되지 않은 군집에서도 자기 지역 성장 촉진의 정책적 의의가 보존됨을 시사한다.
둘째, 군집 간 차이는 광역 파급 차원에서만 명확히 발현된다. 전체 표본의 단일 추정치에서 평균 간접 효과는 통계적으로 유의하지 않으나, 군집별 분해는 이 유의하지 않은 결과가 사실상 C1의 강한 양의 파급과 다른 군집들의 약한 또는 음의 점추정치 효과의 상쇄에 의해 형성된 결과임을 드러낸다. 즉 평균 차원에서 spillover가 유의하게 식별되지 않은 결과가 spillover의 부재를 의미하는 것이 아니라, 반대 방향의 군집별 효과들이 평균에서 상쇄되어 군집 간 차이 자체를 가리는 결과이며, 본 연구의 군집 분해는 그 가림 뒤의 비대칭을 정량적으로 식별한다. C1과 다른 모든 군집 사이의 차이는 단기와 장기, 간접 효과와 총 효과의 모든 차원에서 5% 수준에서 차별화되며, C1 장기 총 효과의 약 87%가 광역 파급에서 발생한다. 이는 C1의 성장 효과가 광역 노동시장권의 인근 지역 고용으로 이어지고 있음을 의미한다.
셋째, 모형의 적합성 차원에서 두 가지 일관된 패턴이 확인된다. 시차 자기회귀 계수가 음의 부호로 식별되어 모든 군집에서 장기 효과가 단기 효과보다 약 12% 낮게 관찰된다. 이는 동적 SDM 채택을 통해 비로소 단기와 장기의 분리 식별이 가능해짐을 의미한다. 또한 GRDP 표준화 평균 순위와 취업자 표준화 평균 순위 사이에서 C4와 C2의 위치 역전이 나타나, C4의 자본·생산성 집약 구조와 C2의 노동 집약 서비스 구조라는 정적 차원의 차별화가 동적 SDM 기반 장기 직접 효과의 점추정 패턴에서도 일관되게 나타난다.
넷째, 한 가지 추가 관찰이 점추정 차원에서 보고된다. C2의 장기 간접 효과 점추정치는 4개 군집 중 유일하게 음의 부호를 보이며, C1과 C2의 쌍별 검정 통계량이 6개 쌍 중 가장 크게 식별된다. 이는 C2가 음의 광역 파급을 발생시킬 가능성을 점추정 차원에서 시사하나, 그 해석은 점추정치 차원에 한정된다.
이상의 발견은 한국 지역 노동시장 정책의 설계가 공통 축과 차별 축의 이중 구조로 접근될 필요성을 시사한다. 직접 메커니즘이 모든 군집에서 보편적으로 작동한다는 사실은 자기 지역 성장-고용 연계 강화가 모든 군집에 공통으로 유효한 정책 축임을 의미한다. 광역 파급이 통계적으로 식별되는 군집은 C1에 한정되나, 다른 모든 군집에서도 자기 지역 직접 효과는 유의하게 작동하므로 자기 지역 성장 촉진의 정책적 의의가 보존된다. 차별 축의 차원에서, 광역 파급 역량의 군집별 분화는 정책 단위의 차별화 필요성을 시사한다(Tödtling and Trippl, 2005). C1에 대한 정책은 자기 지역 단위가 아닌 광역 노동시장권 차원의 매칭 효율 제고와 사업체 생태계 질적 고도화에 초점을 둘 수 있다. C2에서는 노동 집약 서비스 구조에 근거한 자기 지역 매칭 효율 강화가 적합하다. C3에서는 직접 효과가 다른 군집 대비 가장 약하게 식별된다는 점에서 자기 지역 성장 촉진과 함께 인근 핵심부와의 공간적 통합 강화 및 노동공급 기반 확충이 결합된 장소 기반 정책(place-based policy)이 적합하다(Partridge et al., 2015). C4에서는 산업 다변화와 노동시장 유연성 제고가 검토 가능하다.
본 연구는 몇 가지 한계를 내포한다. 첫째, 경기 비대칭성과 2022년 이후 구조 변화를 충분히 반영하지 못하였다. 둘째, 노동시장은 행정경계를 넘어 작동하며 기초자치단체 단위 분석은 MAUP에서 자유롭지 않다(Openshaw, 1984; Kangasharju et al., 2012). 본 연구는 공간적 상호작용을 동적 SDM의 공간시차 항으로 명시적으로 통제하였으나, 통근권 또는 functional labour market areas로의 분석 단위 전환을 통한 정밀 분석은 후속 연구의 핵심 과제로 남긴다. 그럼에도 본 연구는 평균 차원에서 가려져 있던 광역 파급의 군집별 비대칭을 군집 분해를 통해 정량적으로 식별하였다는 점에서 한국 지역 노동시장 정책의 공간적 차별화를 위한 실증적 토대를 제공한다.
Acknowledgments
이 논문은 2021년 대한민국 교육부와 한국연구재단의 지원을 받아 수행된 연구임(NRF-2021S1A3A2A01087370).
Notes
References
-
구재운·배진성·박지섭, 2021. “생산 증가가 고용에 미치는 효과: 전라남도 시·군 자료를 이용한 분석”, 「한국지역경제연구」, 19(3): 109-131.
Koo, J.W., Bae, J.S., and Park, J.S., 2021. “The Effects of Production on Employment: An Analysis Using Jeonnam Province Data“, Journal of the Korean Regional Economics, 19(3): 109-131. [https://doi.org/10.34282/krea.2021.19.3.5]
-
김용현, 2005. “‘고용없는 성장(Jobless Growth)’ 현실인가?”, 「노동정책연구」, 5(3): 35-62.
Kim, Y.H., 2005. “Jobless Growth is It Reality?”, Quarterly Journal of Labor Policy, 5(3): 35-62. -
민보경·최지선, 2023. “생활인구 개념을 반영한 지역 유형화 분석: 전국 기초자치단체를 중심으로”, 「도시행정학보」, 36(4): 41-60.
Min, B.G. and Choi, J.S., 2023. “Characterizing Regions Based on the De Facto Population: Focusing on the Local Areas in South Korea”, Journal of the Korean Urban Management Association, 36(4): 41-60. [https://doi.org/10.36700/KRUMA.2023.12.36.4.41]
-
박세준·박창현·오용연, 2013. “경기–고용간 관계 변화의 구조적 요인 진단과 정책적 시사점”, 「BOK 이슈노트」, 8.
Park, S.J., Park, C.H., and Oh, Y.Y., 2013. “Diagnosis of Structural Factors Behind Changes in the Business Cycle-Employment Relationship and Policy Implications”, BOK Issue Note, 8. -
손경현·김의준, 2025. “청년고용의 수도권 프리미엄”, 「국토계획」, 60(6): 114-129.
Son, K.H. and Kim, E.J., 2025. “Regional Disparities in Youth Employment”, Journal of Korea Planning Association, 60(6): 114-129. [https://doi.org/10.17208/jkpa.2025.11.60.6.114]
-
송민경·장훈, 2010. “군집분석을 이용한 수도권 도시의 유형화에 관한 연구”, 「대한공간정보학회지」, 18(1): 83-88.
Song, M.K. and Chang, H., 2010. “Charaterization of Cities in Seoul Metropolitan Area by Cluster Analysis”, The Journal of Korean Society for Geospatial Information Science, 18(1): 83-88. -
심재훈, 2008. “지역별 고용탄력성 추정 및 추세분석”, 「고용이슈」, 12: 149-167.
Shim, J.H., 2008. “Estimation and Trend Analysis of Regional Employment Elasticity”, Employment Issue, 12: 149-167. -
이연호·이창민, 2020. “고용탄력성을 통해 살펴본 성장과 고용의 관계: 충북 사례를 중심으로”, 「한국경제연구」, 38(1): 67-97.
Lee, Y.H. and Lee, C.M., 2020. “The Relationship between Growth and Employment Examined through Employment Elasticity: Focusing on the Chungbuk Province”, Journal of Korean Economic Studies, 38(1): 67-97. [https://doi.org/10.46665/jkes.2020.03.38.1.67]
-
정현준·권남훈·김원중, 2023. “산업별 고용탄력성 결정요인 연구”, 「정보통신정책연구」, 30(4): 1-30.
Jung, H.J., Kwon, N.H., and Kim, W.J., 2023. “Determinants of Employment Elasticity in Korea”, International Telecommunications Policy Review, 30(4): 1-30. [https://doi.org/10.37793/ITPR.30.4.1]
-
최창곤, 2021. “고용탄력성을 이용한 최근 고용추이해석”, 「경제연구」, 39(1): 115-131.
Choi, C.K., 2021. “Interpretation of Recent Employment Data Using Employment Elasticity”, Journal of Economic Studies, 39(1): 115-131. [https://doi.org/10.30776/JES.39.1.5]
-
최호현·김선범, 2006. “요인분석과 군집분석을 이용한 용도지역의 특성과 유형분류”, 「한국도시지리학회지」, 9(1): 127-136.
Choi, H.H. and Kim, S.B., 2006. “The Characterisitics and Types of Urban Zoning Areas by Factor Analysis and Cluster Analysis in Korea”, Journal of the Korean Urban Geographical Society, 9(1): 127-136. -
Anselin, L., 1988. Spatial Econometrics: Methods and Models (Vol. 4), New York: Springer Science & Business Media.
[https://doi.org/10.1007/978-94-015-7799-1]
- Bande, R. and Martín-Román, Á., 2018. “Regional Differences in the Okun’s Relationship: New Evidence for Spain (1980-2015)”, Investigaciones Regionales-Journal of Regional Research, (41): 137-165.
-
Belotti, F., Hughes, G., and Mortari, A.P., 2017. “Spatial panel-data models using Stata”, The Stata Journal, 17(1): 139-180.
[https://doi.org/10.1177/1536867X1701700109]
-
Biddle, J.E., 2014. “Retrospectives: The Cyclical Behavior of Labor Productivity and the Emergence of the Labor Hoarding Concept”, Journal of Economic Perspectives, 28(2): 197-212.
[https://doi.org/10.1257/jep.28.2.197]
-
Blanchard, O.J., Katz, L.F., Hall, R.E., and Eichengreen, B., 1992. “Regional Evolutions”, Brookings Papers On Economic Activity, 1992(1): 1-75.
[https://doi.org/10.2307/2534556]
-
Caliński, T. and Harabasz, J., 1974. “A Dendrite Method for Cluster Analysis”, Communications in Statistics-theory and Methods, 3(1): 1-27.
[https://doi.org/10.1080/03610927408827101]
-
Choi, J. and Kim, I., 2017. “Regional Total Factor Productivity and Local Employment Growth: Evidence from Korea”, Asia-Pacific Journal of Regional Science, 1(2): 511-518.
[https://doi.org/10.1007/s41685-017-0053-1]
-
Combes, P.P. and Gobillon, L., 2015. “The Empirics of Agglomeration Economies”, In Handbook of Regional and Urban Economics (Vol. 5), 247-348, Elsevier.
[https://doi.org/10.1016/B978-0-444-59517-1.00005-2]
-
Combes, P.P., Duranton, G., and Gobillon, L., 2008. “Spatial Wage Disparities: Sorting Matters!”, Journal Of Urban Economics, 63(2): 723-742.
[https://doi.org/10.1016/j.jue.2007.04.004]
-
Cortinovis, N. and van Oort, F., 2015. “Variety, Economic Growth and Knowledge Intensity of European Regions: A Spatial Panel Analysis”, The Annals of Regional Science, 55(1): 7-32.
[https://doi.org/10.1007/s00168-015-0680-2]
-
Duranton, G. and Puga, D., 2004. “Micro-foundations of Urban Agglomeration Economies”, In Handbook of Regional and Urban Economics (Vol. 4), 2063-2117, Elsevier.
[https://doi.org/10.1016/S1574-0080(04)80005-1]
-
Elhorst, J.P., 2014. Spatial Econometrics: From Cross-sectional Data to Spatial Panels, Heidelberg: Springer.
[https://doi.org/10.1007/978-3-642-40340-8]
-
Hoogstra, G.J., Van Dijk, J., and Florax, R.J., 2017. “Do Jobs Follow People or People Follow Jobs? A Meta-analysis of Carlino-Mills Studies”, Spatial Economic Analysis, 12(4): 357-378.
[https://doi.org/10.1080/17421772.2017.1340663]
- Hsiao, C., 1986. Analysis of Panel Data, Cambridge University Press.
-
IMF, 2013. Jobs and Growth: Analytical and Operational Considerations for the Fund, International Monetary Fund.
[https://doi.org/10.5089/9781498342148.007]
-
Kaiser, H.F., 1960. “The Application of Electronic Computers to Factor Analysis”, Educational and Psychological Measurement, 20(1): 141-151.
[https://doi.org/10.1177/001316446002000116]
-
Kangasharju, A., Tavera, C., and Nijkamp, P., 2012. “Regional Growth and Unemployment: The Validity of Okun's Law for the Finnish Regions”, Spatial Economic Analysis, 7(3): 381-395.
[https://doi.org/10.1080/17421772.2012.694141]
-
Kim, D. and Hong, S., 2019. “Regional Business Cycles and Employment Resilience in Korean Regions”, Area Development and Policy, 4(3): 236-251.
[https://doi.org/10.1080/23792949.2018.1537718]
-
Krause, M. and Kripfganz, S., 2025. “Regional Dependencies and Local Spillovers: Insights from Commuter Flows”, Journal of Regional Science, 65(3): 565-585.
[https://doi.org/10.1111/jors.12752]
-
LeSage, J. and Pace, R.K., 2009. Introduction to Spatial Econometrics, Chapman and Hall/CRC.
[https://doi.org/10.1201/9781420064254]
-
Neyman, J. and Scott, E.L., 1948. “Consistent Estimates Based on Partially Consistent Observations”, Econometrica: Journal of the Econometric Society, 16(1): 1-32.
[https://doi.org/10.2307/1914288]
-
Nickell, S., 1981. “Biases in Dynamic Models with Fixed Effects”, Econometrica: Journal of the Econometric Society, 49(6): 1417-1426.
[https://doi.org/10.2307/1911408]
-
Oi, W.Y., 1962. “Labor as a Quasi-fixed Factor”, Journal of Political Economy, 70(6): 538-555.
[https://doi.org/10.1086/258715]
- Okun, A.M., 1963. Potential GNP: Its Measurement and Significance, Cowles Foundation for Research in Economics at Yale University.
- Openshaw, S., 1984. “The Modifiable Areal Unit Problem”, In Concepts and Techniques in Modern Geography, Geo Books.
-
Park, J. and Kim, D., 2025. “Regional Economic Resilience and Long-term Employment Growth: Decomposing Structural Transitions in South Korean Metropolitan Areas”, The Annals of Regional Science, 74(2): 54.
[https://doi.org/10.1007/s00168-025-01383-5]
-
Partridge, M.D., Rickman, D.S., Olfert, M.R., and Tan, Y., 2015. “When Spatial Equilibrium Fails: Is Place-based Policy Second Best?”, Regional Studies, 49(8): 1303-1325.
[https://doi.org/10.1080/00343404.2013.837999]
-
Tödtling, F. and Trippl, M., 2005. “One Size Fits All?: Towards a Differentiated Regional Innovation Policy Approach”, Research Policy, 34(8): 1203-1219.
[https://doi.org/10.1016/j.respol.2005.01.018]
-
Woo, J., 2023. “Revisiting Okun’s Law in South Korea: Asymmetries, Crises, and Structural Changes”, The Journal of Economic Asymmetries, 27: e00292.
[https://doi.org/10.1016/j.jeca.2023.e00292]
-
Yu, J., De Jong, R., and Lee, L.F., 2008. “Quasi-maximum Likelihood Estimators for Spatial Dynamic Panel Data with Fixed Effects When Both n and T Are Large”, Journal of Econometrics, 146(1): 118-134.
[https://doi.org/10.1016/j.jeconom.2008.08.002]
-
Yu, S. and Kim, D., 2021. “Changes in Regional Economic Resilience after the 2008 Global Economic Crisis: The Case of Korea”, Sustainability, 13(20): 11392.
[https://doi.org/10.3390/su132011392]