서울 주택시장에서 범죄율, 고용 중심성, 그리고 주택가격의 관계: 공간적 의존성을 고려한 자치구 분석
 ; 이해민**
; 김진화***
; 이상근****
; Lee, Haemin**
; Kim, Jinhwa***
; Lee, Sang Gun****
Abstract
This study examines how crime rates and employment centrality are associated with housing prices in Seoul while accounting for spatial dependence. Using a district–year panel dataset covering Seoul’s 25 districts from 2019 to 2024, supplemented by transaction-level fixed-effects analyses, the study combines fixed-effects models, spatial diagnostic tests using Moran’s I and LISA, and supplementary spatial econometric models. The results show that housing prices in Seoul exhibit strong and persistent spatial clustering, indicating that local housing markets are embedded in a stable spatial structure rather than determined independently. The findings also show that both crime rates and employment centrality are positively associated with housing prices, even after controlling for demographic and neighborhood-level factors. This suggests that the positive relationship between crime and housing prices cannot be explained simply by the omission of employment centrality. Rather, the results are more consistent with the interpretation that, in a dense metropolitan context, high-priced districts often coincide with areas of concentrated economic activity, accessibility advantages, and higher crime exposure. Additional analyses indicate that this pattern is more pronounced in districts with relatively high levels of employment centrality. Overall, the study suggests that the relationship between crime exposure, safety-related indicators, and housing prices in Seoul should be understood as part of a complex urban spatial structure in which agglomeration benefits and crime exposure are jointly observed.
Keywords:
Crime Rates, Housing Prices, Employment Centrality, Spatial Dependence, Social Safety키워드:
범죄율, 주택가격, 고용 중심성, 공간의존성, 사회안전Ⅰ. 서 론
1. 연구의 배경 및 목적
현대 도시에서 주거환경의 가치는 더 이상 주택의 물리적 특성에만 국한되지 않으며, 거주민의 삶의 질을 형성하는 사회적·환경적 입지 요인을 포괄하는 방향으로 확장되고 있다. 전통적인 티부 가설(Tiebout, 1956)이 시사하듯, 가계는 공공서비스의 수준, 안전, 어메니티(amenity)가 상대적으로 우수한 지역을 선택적으로 선호하며, 이러한 선호는 주택가격에 자본화(capitalization)되어 반영된다(Oates, 1969). 특히 범죄로부터의 안전, 재난 위험, 교통사고 가능성 등으로 대표되는 사회안전(social safety) 요인은 거주 만족도와 지역 선호도를 결정하는 핵심 요소로 기능하며, 다수의 선행연구에서 주택가격 형성 과정에 유의미한 영향을 미치는 요인으로 보고되어 왔다(Gibbons, 2004; Ceccato and Wilhelmsson, 2011).
이러한 인식에 따라 중앙정부와 지방자치단체는 범죄, 화재, 교통, 보건 등 다양한 위험 요인을 종합적으로 반영한 지역안전지수(LSLI), 사회안전지수(KSI) 등 복합 안전지표를 구축·공표하고 있다. 그러나 이와 같은 거시적 안전 지표가 실제 부동산 시장, 특히 서울과 같은 고밀도 대도시의 주택가격에 어떠한 방식으로 반영되는지에 대해서는 실증적 분석이 충분히 축적되지 못한 실정이다. 기존 연구들은 개별 안전 요소를 단편적으로 다루거나, 안전을 주택가격의 부차적 결정요인으로 취급하는 경향을 보여 왔다(나은지 외, 2024; 김갑열·김윤옥, 2017).
주택가격 결정요인에 관한 전통적인 연구들은 교통 접근성, 교육 환경, 인구 구조와 같은 입지 및 환경 요인에 주로 초점을 맞추어 왔으며(Rosen, 1974; O’Sullivan, 2012), 안전 요인은 대체로 범죄 발생 건수와 같은 단일한 객관적 지표를 통해 제한적으로 분석되어 왔다. 서구의 헤도닉 가격모형 연구에서는 범죄를 주택가격에 부정적 외부효과(negative externality)를 초래하는 위험요인으로 간주하는 경우가 많았다(Thaler, 1978; Linden and Rockoff, 2008). 그러나 최근 도시경제학 연구들은 고밀도 대도시 맥락에서 범죄율이 단순한 위험 신호에 그치지 않고, 상업 활동, 유동인구, 고용 중심성, 도시 기능의 집적과 함께 나타나는 복합적 현상일 가능성을 제기하고 있다(Glaeser and Sacerdote, 1996; Bowes and Ihlanfeldt, 2001). 이는 범죄 발생 빈도가 높은 지역에서 주택가격이 오히려 높게 관찰되는 현상을 단순한 안전 선호의 문제로 해석하기 어렵다는 점을 시사한다. 따라서 이러한 양(+)의 관계가 범죄 자체의 가격효과를 의미하는지, 아니면 중심지 특성 및 경제활동 집적과 함께 관찰되는 도시공간의 복합적 구조를 반영하는지에 대해서는 보다 신중한 검토가 필요하다.
한편, 주택가격은 개별 지역에서 독립적으로 결정되기보다는 인접 지역과의 상호작용 속에서 형성되는 강한 공간적 의존성(spatial dependence)을 지닌다(Pace and Gilley, 1997). 공간계량경제학 문헌에서는 이러한 공간적 파급효과(spillover effect)를 명시적으로 통제하지 않을 경우, 추정 계수가 편의(bias)를 갖거나 일치성을 상실할 수 있음을 반복적으로 지적해 왔다(Anselin, 1988; LeSage and Pace, 2009). 서울시는 고가 주택지와 저가 주택지가 뚜렷한 공간적 군집을 이루는 대표적인 대도시로서 주택가격분석에 있어 공간적 상호작용을 명시적으로 고려할 필요성이 특히 크다(이윤상 외, 2022).
이에 본 연구는 2019년부터 2024년까지의 기간을 대상으로 서울시 25개 자치구를 분석 단위로 하는 자치구-연도 패널 자료를 구축하고, 사회안전 요인과 주택가격 간의 관계를 중심지 특성의 맥락에서 재검토하고자 한다. 본 연구는 이중 고정효과 패널 모형과 Moran’s I, LISA, 공간모형(SLM, SEM)을 보완적으로 활용하여 주택가격의 공간적 자기상관을 진단하고 점검하는 한편, 지역의 고용 규모(종사자 수)를 중심지의 경제적 집적을 나타내는 대리변수로 포함하여 범죄와 주택가격간에 관찰되는 양(+)의 관계가 고용 중심성과 같은 도시 기능의 집적을 고려한 뒤에도 유지되는지를 살펴본다. 이를 통해 범죄율과 주택가격의 관계를 단일한 방향의 인과로 단정하기보다, 대도시 공간구조 속에서 함께 나타나는 연관성의 양상으로 보다 신중하게 해석하고자 한다.
구체적으로 본 연구는 첫째, Moran’s I 및 국지적 공간 자기상관 지표(LISA)를 활용하여 서울시 주택가격의 공간적 군집 구조와 그 지속성을 진단한다. 둘째, 공간적 상호의존성과 중심지의 경제적 집적 요인을 함께 고려한 상태에서 범죄 및 사회안전 지표와 주택가격간의 관계를 재검토한다. 셋째, 이를 통해 고밀도 대도시에서 높은 주택가격, 높은 고용 중심성, 그리고 높은 범죄 노출이 어떠한 방식으로 함께 관찰되는지를 살펴보고, 서울 주택시장의 안전과 가격 관계를 보다 입체적으로 이해할 수 있는 실증적 근거를 제시하고자 한다.
Ⅱ. 이론적 배경 및 선행연구 검토
1. 주거 안전과 도시 활력의 경제적 가치
주택은 단순한 물리적 구조물이 아니라, 입지(location)가 제공하는 다차원적 속성, 곧 물리적 특성, 접근성, 어메니티(amenity), 공공서비스 수준 등이 결합된 재화이다. Rosen(1974)의 헤도닉 가격 모형(hedonic price model)은 이러한 속성들의 묶음(bundle of attributes)이 시장 균형 하에서 내재가격(implicit price)을 형성하는 과정을 설명한다. 전통적으로 주거 안전(safety)은 소비자의 효용과 주택가격에 반영되는 중요한 입지 특성으로 이해되어 왔다. 한편 고밀도 대도시 주택시장에서는 안전과 더불어 상업 및 고용 중심지에 대한 접근성, 그리고 경제활동의 집적에서 비롯되는 편익 역시 가격 형성에 중요한 역할을 할 수 있다. Jacobs(1961)는 다양한 도시 활동이 만들어내는 활력을 도시 공간의 핵심 특성으로 보았으며, 도시경제학 논의에서도 중심지 접근성과 경제적 집적이 주택가격 형성의 중요한 배경으로 다루어져 왔다(O’Sullivan, 2012). 다만 본 연구에서 주목하는 것은 추상적 의미의 도시 활력 전반이라기보다, 그 가운데 고용 중심성과 중심지 기능에 가까운 측면이다. 따라서 대도시 주택 가격 형성 과정을 이해하기 위해서는 안전 요인과 함께 고용 중심성 및 경제적 집적이 어떠한 방식으로 동시에 작동하는지를 함께 살펴볼 필요가 있다.
2. 범죄와 주택가격
주택시장에 관한 전통적인 연구들은 범죄를 대표적인 비선호 요인(disamenity)이자 부정적 외부효과(negative externality)로 규정해 왔다. Thaler(1978)는 높은 범죄율이 주택 가치를 하락시키는 요인으로 작용할 수 있음을 보였으며, 다수의 서구권 연구들 또한 범죄와 주택 가격 간의 부(-)의 관계를 보고하였다(Gibbons, 2004; Linden and Rockoff, 2008). 이러한 논의는 시장 참여자들이 가격을 지불해서라도 범죄 위험을 회피하려 한다는 가정에 기초한다. 그러나 최근 연구들은 고밀도 대도시 환경에서 범죄와 주택 가격의 관계가 반드시 단순한 음(-)의 형태로만 나타나지 않을 가능성을 지적한다. Glaeser and Sacerdote(1996)는 범죄율이 높은 지역이 동시에 높은 인구 밀도와 상업적 집적을 보이는 경향에 주목하며, 범죄가 도시의 경제적 번영과 유동인구 증가에 수반되어 나타날 수 있음을 제기하였다.
이 관점에서 범죄는 독립적인 위험 신호에 그치지 않고, 중심지의 기능적 집적과 함께 관찰되는 현상으로 이해될 여지가 있다. Bowes and Ihlanfeldt(2001)는 교통 접근성과 같은 중심지 편익이 주택 가격에 자본화될 수 있음을 보여주었다. 이러한 논의는 중심지 접근성이 큰 지역에서는 범죄 노출과 같은 비선호 요인이 존재하더라도 가격 형성 양상이 단순하지 않을 수 있음을 시사한다. 국내 연구에서도 Lee(2022)는 폭력 범죄의 핫스팟이 상업 활동이 활발한 지역과 공간적으로 중첩되는 경향을 보고한 바 있다. 이러한 논의는 대도시에서 범죄와 주택 가격의 관계를 해석할 때 범죄를 단일한 위험 변수로만 보기보다, 고용 중심성, 상업 집적, 접근성과 같은 중심지 특성과 함께 검토할 필요가 있음을 보여준다. 다시 말해, 범죄와 주택 가격 간에 관찰되는 양(+)의 관계는 단순한 위험 선호의 결과라기보다, 대도시 공간구조 속에서 여러 도시적 속성이 함께 응축되어 나타나는 양상으로 이해될 필요가 있다.
3. 객관적 위험과 주관적 인식의 괴리
주택 가격은 객관적으로 측정된 위험 수준(objective measures)뿐만 아니라, 시장 참여자들이 인식하는 주관적 위험과 안전 인식(subjective perceptions)에 의해서도 영향을 받을 수 있다. 행동경제학 연구에 따르면, 개인은 낮은 확률의 위험을 과대평가하거나 일상적으로 반복되는 위험에는 둔감해지는 경향을 보인다(Kahneman and Tversky, 1979). 이러한 인지적 편향은 주거 선택과 주택 가격 형성 과정에서도 중요한 의미를 갖는다. 실제 범죄 발생 통계와 주민들이 인식하는 안전 수준 사이에는 적지 않은 괴리가 존재하며, 주택가격은 객관적 범죄 발생률 그 자체보다 주민이 체감하는 안전 수준(perceived safety)에 더 민감하게 반응할 가능성도 제기되어 왔다(Buonanno et al., 2013). 특히 현대 도시에서 안전의 개념은 물리적 범죄 위험에만 한정되지 않고, 질병, 화재, 교통사고 등 생활 전반의 위험 요소를 포괄하는 사회안전(social safety)의 차원으로 확장되고 있다. 그럼에도 기존 연구들은 단일 범죄 지표에 지나치게 의존하는 경향이 있어, 안전의 다차원적 속성이 주택 가격에 어떠한 방식으로 반영되는지를 충분히 설명하지 못했다. 이러한 점은 객관적 범죄 지표와 더불어 주민의 체감 안전이나 사회안전지표를 함께 검토할 필요가 있음을 보여준다. 다만 두 지표는 서로 다른 차원의 안전을 반영할 수 있으므로, 하나를 다른 하나의 단순한 대체물로 보기보다 상호 보완적인 정보로 해석할 필요가 있다.
4. 주택시장의 공간적 의존성과 공간계량 모형의 필요성
주택 가격은 개별 주택이나 지역의 특성에 의해서만 독립적으로 결정되기보다, 인접 지역의 가격 수준과 환경 변화로부터 영향을 받는 강한 공간적 의존성(spatial dependence)을 지닌다(Anselin, 1988). 이는 주택시장 정보의 공간적 확산(spillover), 학군·교통·상권과 같은 어메니티의 공유, 그리고 인접 지역 간 대체 관계에서 비롯된다. LeSage and Pace(2009)는 이러한 공간적 상호작용을 무시한 채 일반 회귀모형을 적용할 경우, 추정 결과의 신뢰성이 저하될 수 있음을 지적하였다. 서울시는 고가 주택지와 저가 주택지가 뚜렷한 공간적 군집을 형성하는 대표적인 대도시로 알려져 있다. 김지영·김은정(2019)은 서울시 아파트단지를 대상으로 핫스팟 분석과 LISA 분석을 수행하여 아파트 가격에 공간적 자기상관성이 존재하며, 고가 지역과 저가 지역 사이에 근린환경 및 기반시설 접근성의 차이가 나타남을 보였다. 김연미(2008) 역시 서울 아파트 실거래가 패널 데이터를 이용한 공간 군집 분석을 통해 고가 및 저가 지역의 공간 구조가 시계열적으로 안정적인 패턴을 유지하고 있음을 보였으며, Kwon and Hwang(2023)도 베이지안 공간 자기회귀 모형을 적용하여 인구통계학적 요인을 통제한 뒤에도 서울 주택 가격에 강한 공간적 의존성이 존재함을 확인하였다.
이러한 선행연구를 고려할 때, 서울 주택시장에서 범죄, 중심지 특성, 주택 가격 간의 관계를 검토할 때에도 공간적 상호작용을 명시적으로 고려할 필요가 있다. 특히 범죄 노출이나 안전에 대한 지역적 평판, 그리고 중심지의 편익은 행정구역 경계를 넘어 인접 지역으로 확산될 수 있으므로, 공간 시차 모형(spatial lag model)과 공간 오차 모형(spatial error model)을 활용한 점검은 분석의 강건성을 높이는 데 유용하다. 다만 공간모형은 공간적 의존성을 보다 적절히 반영하기 위한 방법론적 보완 장치로 이해할 필요가 있으며, 그 결과 역시 공간가중행렬의 설정과 모형 사양에 따라 달라질 수 있다는 점에서 신중한 해석이 요구된다.
5. 선행연구와의 차별성
이상의 논의를 바탕으로, 본 연구의 차별성은 다음과 같이 정리할 수 있다. 먼저 본 연구는 서울 주택시장에서 범죄율과 주택가격 간에 관찰되는 관계를 고용 중심성과 같은 중심지 특성의 맥락에서 다시 검토한다는 점에서 기존 연구와 구별된다. 기존 연구들이 범죄를 주택 가격에 부정적 영향을 미치는 단일한 위험 변수로 다루거나, 반대로 범죄와 가격 간의 양(+)의 관계를 단편적으로 해석하는 경향이 있었다면, 본 연구는 범죄 노출이 높은 지역이 동시에 고용과 상업 기능이 집적된 중심지일 가능성에 주목한다. 이를 통해 범죄와 주택 가격의 관계를 단순한 안전 선호 또는 단일 변수의 효과로 환원하지 않고, 대도시 공간구조 속에서 함께 나타나는 복합적 현상으로 해석하고자 한다.
또한 본 연구는 방법론적으로 공간적 의존성과 시간적 변동을 함께 고려하여 분석을 수행한다는 점에서 의의를 가진다. 서울 주택시장은 자치구 간 가격 수준이 독립적으로 형성되기보다 인접 지역과의 상호작용 속에서 움직이는 경향이 강하므로, 주택 가격의 공간적 군집을 Moran’s I와 LISA를 통해 진단하고, 고정효과 모형을 기본으로 하되 공간모형을 보완적으로 활용하여 이러한 공간구조를 점검하였다. 이는 범죄율, 고용 중심성, 그리고 주택 가격 간의 관계를 보다 신중하게 검토하기 위한 분석 틀을 제시한다는 점에서 의미가 있다.
아울러 본 연구는 2019년부터 2024년까지의 패널 자료를 활용하여 팬데믹 전후 서울 대도시의 변화 양상을 반영하고, 객관적 범죄 지표와 사회안전 관련 지표를 함께 검토하였다는 점에서도 차별성을 갖는다. 이를 통해 서울과 같은 고밀도 대도시에서 높은 주택 가격, 높은 고용 중심성, 그리고 높은 범죄 노출이 어떠한 방식으로 함께 관찰되는지를 실증적으로 살펴보고, 주택시장과 도시 안전의 관계를 보다 입체적으로 이해할 수 있는 근거를 제시하고자 한다.
Ⅲ. 연구방법(Methodology)
1. 분석 자료 및 변수 구성
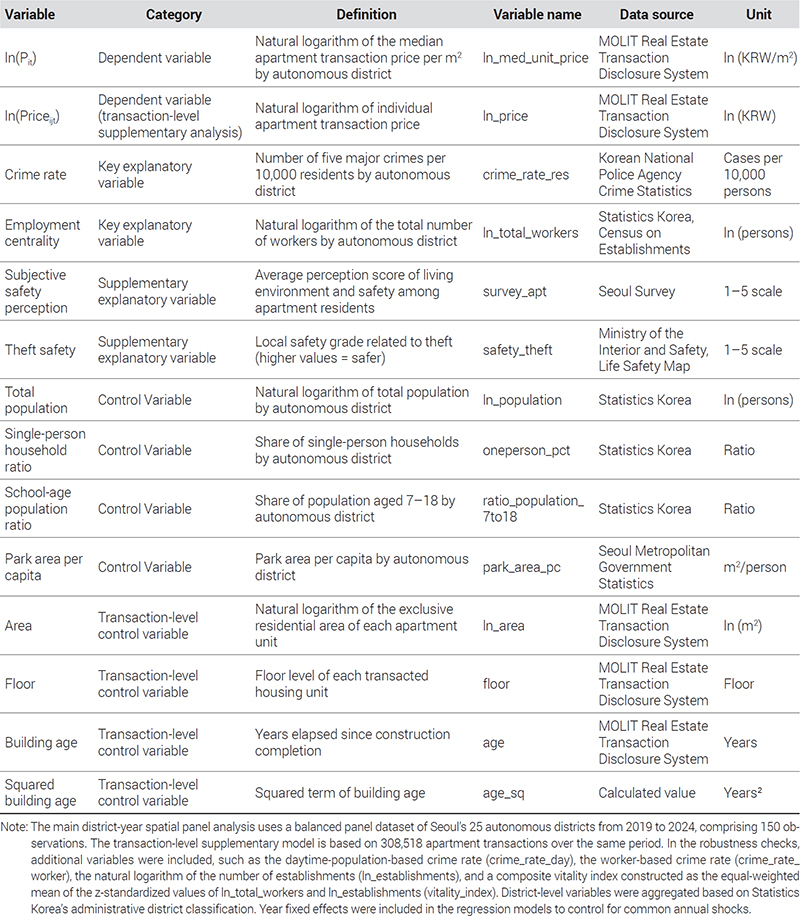
본 연구는 2019년부터 2024년까지 서울시 25개 자치구를 대상으로 하는 자치구-연도(district-year) 균형 패널 자료를 구축하였다. 변수의 정의와 자료 출처는 <Table 1>에 정리하였다. 기본적인 공간 진단과 자치구-연도 수준 분석은 25개 자치구의 6개 연도에 해당하는 150개 관측치를 바탕으로 수행하였다. 다만 자치구 단위 집계자료의 한계를 보완하기 위해, 거래단위 자료 308,518건을 활용한 추가 고정효과 회귀와 강건성 검정을 함께 수행하였으며, 본문의 핵심 계수 해석은 이 거래단위 분석을 중심으로 제시한다.

Variable definitions and data sources
자치구-연도 수준의 기본 분석에서 종속변수는 자치구별 아파트 m2당 중위 실거래가격의 자연로그 값인 ln(Pit)이다. 이는 집계자료상 ln_med_unit_price에 해당한다. 평균이 아니라 중앙값을 사용한 것은 초고가 거래가 집계가격을 과도하게 왜곡할 가능성을 줄이기 위해서이며, 로그 변환은 가격 분포의 비대칭성을 완화하고 계수를 탄력성의 형태로 해석할 수 있도록 해준다(Wooldridge, 2012). 주택가격 변수는 명목가격 기준으로 정리하였으며, 회귀분석에서는 연도 고정효과를 포함하여 연도별 공통 가격수준 변화를 통제하였다. 거래단위 보완 분석에서는 개별 아파트 거래가격의 자연로그를 종속변수로 사용하고, 추가 강건성 검정에서는 단위면적 가격을 활용한 모형도 함께 추정하였다.
본 연구의 핵심 설명변수는 범죄율과 고용 중심성이다. 먼저 범죄율(crime_rate_res)은 자치구별 인구 1만 명당 5대 범죄 발생 건수로 측정하였다. 이는 서울 주택시장에서 객관적 범죄 노출이 가격과 어떠한 관계를 보이는지를 파악하기 위한 기본 지표이다. 다음으로 ln_total_workers는 자치구별 총종사자 수의 자연로그값으로, 고용 중심성과 중심지 기능의 집적을 나타내는 대리변수로 사용하였다. 이는 추상적 의미의 도시 활력 전체를 직접 측정한다기보다, 중심지의 경제활동 밀도와 기능적 집적을 반영하는 지표로 이해하는 것이 적절하다.
추가 강건성 검정에서는 활동인구 기준 범죄율(crime_rate_day), 종사자 수 기준 범죄율(crime_rate_worker), 사업체 수의 자연로그(ln_establishments), 그리고 ln_total_workers와 ln_establishments를 각각 표준화한 후 동일 가중 평균하여 구성한 복합 도시활력지수(vitality_index)를 함께 활용하였다.
이와 함께 본 연구는 안전의 다차원적 성격을 보다 폭넓게 검토하기 위해 절도 안전(safety_theft)과 같은 지역안전등급 변수를 보조 설명변수로 활용하였다. 또한 서울서베이의 아파트 거주민 대상 설문 지표(survey_apt)를 이용하여 주관적 안전 인식이 가격과 어떠한 관련성을 보이는지도 추가적으로 점검하였다. 이러한 변수들은 주된 설명변수라기보다 객관적 범죄 지표와 고용 중심성 변수의 해석을 보완하기 위한 추가 분석 변수로 사용하였다.
통제변수로는 자치구의 주택 수요 및 생활환경을 반영하는 총인구의 자연로그값(ln_population), 1인 가구 비율(oneperson_pct), 학령인구(7-18세) 비율(ratio_population_7to18), 1인당 공원면적(park_area_pc)을 포함하였다. 거래단위 보완 회귀에서는 개별 주택의 구조적 특성을 통제하기 위해 면적의 자연로그(ln_area), 층수(floor), 경과연수(age), 경과연수 제곱항(age_sq)을 함께 포함하였다. 이들 변수는 인구 규모, 가구 구조, 교육 수요, 생활환경 어메니티 및 주택 자체 특성이 가격에 미치는 영향을 함께 고려하기 위한 것이다.
본 연구가 자치구를 기본 분석 단위로 설정한 것은 서울 주택시장의 공간적 구조와 안전 관련 행정체계의 작동 방식을 함께 고려한 결과이다. 서울 주택시장에서 자치구는 단순한 행정 경계를 넘어 시장 참여자들이 지역의 평판과 중심지 특성을 인식하는 기본 단위로 기능하며, 치안 및 생활안전 관련 정책 역시 상당 부분 자치구 단위에서 집행된다. 이러한 점에서 자치구 수준의 분석은 서울 대도시 주택시장에서 범죄율, 고용 중심성, 그리고 주택가격 간의 관계를 검토하는 데 유의한 출발점이 된다. 동시에 본 연구는 거래단위 분석을 병행함으로써, 자치구 수준 집계자료가 갖는 표본 규모와 공간 해상도의 한계를 보완하고자 하였다.
2. 공간 가중치 행렬(Spatial Weight Matrix)
공간적 상호작용을 분석하기 위해서는 지역 간 인접성을 어떠한 기준으로 정의할 것인지가 선행되어야 한다. 본 연구는 서울시 25개 자치구를 분석 단위로 설정하였으므로, 자치구 간 경계 접합 관계를 반영하는 공간 가중치 행렬(Spatial Weight Matrix, W)을 구축하였다. 구체적으로는 공식 기초단위구 경계 자료를 자치구 단위로 병합한 뒤, 이를 바탕으로 서울 25개 자치구의 공간 경계를 재구성하였다. 이러한 방식은 범죄, 안전, 고용, 주택가격 자료가 모두 자치구 단위로 정리되어 있다는 점에서 분석 자료의 공간 단위와도 정합적이다.
본 연구에서는 물리적 인접성을 기준으로 하는 Queen contiguity 방식을 적용하였다(Anselin, 1988). Queen contiguity는 두 지역이 점 또는 선의 형태로 하나 이상의 경계를 공유할 경우 인접한 것으로 정의하는 방식으로, 다각형 경계를 갖는 행정구역 간 공간적 연결성을 비교적 폭넓게 포착할 수 있다는 장점이 있다. 서울 자치구를 대상으로 구성한 공식 Queen 공간가중행렬에서는 모든 자치구가 인접 관계 안에 포함되어 고립된 지역(island)이 나타나지 않았으며, 이는 서울 주택시장의 연속적 공간구조를 반영하는 데 적절한 조건으로 판단된다. 또한 행렬의 원소 wij는 행 표준화(row-standardization)를 적용하여 각 지역이 인접 지역으로부터 받는 상대적 평균 효과로 해석할 수 있도록 하였다. 이러한 공간 가중치 행렬은 이후 Moran’s I, LISA, 공간시차모형(SLM), 공간오차모형(SEM) 등 공간의존성 진단과 추정의 공통 기반으로 활용하였다.
3. 공간적 자기상관 분석(Spatial Autocorrelation)
주택 가격이 공간적으로 독립적으로 결정된다는 가정은 대도시 주택시장에서는 성립하기 어렵다. 인접 지역 간 정보 확산, 유사한 입지 여건의 공유, 학군·상권·교통 인프라의 공간적 연속성으로 인해 주택 가격은 뚜렷한 공간적 군집(spatial clustering)을 보이는 경향이 있다. 이러한 공간적 의존성을 무시한 채 회귀분석을 수행할 경우, 추정 계수는 편의되거나 통계적 유의성이 왜곡될 수 있다(Anselin, 1988). 이에 본 연구는 공간 회귀모형을 적용하기에 앞서 서울 자치구 주택가격의 공간적 자기상관 존재 여부를 먼저 진단하였다.
이를 위해 공식 공간경계 자료를 바탕으로 구축한 서울 25개 자치구의 Queen contiguity 공간가중행렬을 사용하여 Moran’s I 통계를 산출하였다(Moran, 1950). Moran’s I는 전체 공간 단위에서 변숫값의 유사성이 공간적으로 얼마나 집중되어 있는지를 측정하는 전역적 지표로, 식 (1)과 같이 정의된다.
| (1) |
Cliff and Ord(1973)에 따르면 Moran’s I 값이 양(+)이고 통계적으로 유의할 경우, 고가-고가 또는 저가-저가 지역이 서로 인접하여 분포하는 공간 군집 구조가 존재함을 의미한다. 반대로 음(-)의 값은 상이한 특성을 지닌 지역들이 인접해 있는 공간적 이질성을 시사한다. 본 연구는 연도별 Moran’s I를 산출하여 서울 주택가격의 공간 군집이 일시적 현상인지, 아니면 시계열적으로 지속되는 구조인지를 함께 확인하였다.
아울러 전역적 지표만으로는 개별 자치구 수준에서 나타나는 국지적 군집 양상을 충분히 파악하기 어렵기 때문에, Local Indicators of Spatial Association(LISA)을 추가로 활용하였다(Anselin, 1995). LISA 분석은 각 자치구가 고가-고가, 저가-저가, 고가-저가, 저가-고가 가운데 어떠한 국지적 공간 패턴에 속하는지를 식별할 수 있게 해준다. 이를 통해 서울 주택시장에서 특정 자치구가 공간적 고가 클러스터의 일부인지, 혹은 주변 지역과 상이한 특성을 보이는지 보다 구체적으로 파악하고자 하였다. 이러한 공간적 자기상관 진단은 이후 공간시차모형(SLM)과 공간오차모형(SEM)의 적용 필요성을 판단하는 기초 절차로 활용하였다.
4. 분석 모형
주택 가격은 자치구 고유의 입지적 조건, 역사적 개발 수준, 생활권의 위계, 장기적 평판과 같은 시간에 따라 쉽게 변하지 않는 특성의 영향을 크게 받는다. 이러한 요인을 적절히 통제하지 않을 경우 설명변수와 누락된 불변 특성이 상관될 가능성이 높아 추정치에 편의가 발생할 수 있다(Baltagi, 2005). 이에 본 연구는 자치구 고유의 시간 불변 특성과 연도별 공통 충격을 함께 통제하기 위하여 자치구 고정효과(μi)와 연도 고정효과(λt)를 포함하는 이중 고정효과(Two-Way Fixed Effects) 모형을 기본 분석틀로 설정하였다.
| (2) |
식 (2)에서 ln_total_workersit는 자치구별 총종사자 수의 자연로그값으로, 고용 중심성과 중심지 기능의 집적을 반영하는 대리변수이다. Safetyit는 교통, 화재, 절도, 생활안전, 자살, 감염병 등과 관련된 지역안전지표를 의미하며, crime_rateit는 자치구별 인구 1만 명당 5대 범죄 발생 건수로 측정한 객관적 범죄 노출 수준을 나타낸다. 고정효과 모형은 자치구별 시간 불변 특성을 효과적으로 통제할 수 있다는 장점이 있으므로, 본 연구에서는 이를 기본 모형으로 활용하여 범죄율과 고용 중심성이 주택 가격과 어떠한 관련성을 보이는지를 추정하였다.
이와 함께 본 연구는 연도 고정효과를 포함한 합동 OLS(Pooled OLS) 모형도 보조적으로 활용하였다. 이는 고정효과 모형에서 흡수되는 자치구 간 수준 차이를 별도로 확인하기 위한 것이 아니라, 변수 간 관계의 방향성과 추정 결과의 일관성을 점검하기 위한 보완적 분석이다. 따라서 본 연구의 해석은 기본적으로 이중 고정효과 모형의 결과를 중심으로 하되, OLS 결과는 보조적 참고 자료로 제시한다.
공간적 자기상관이 확인된 경우, 일반적인 패널 회귀모형만으로는 인접 지역 간 가격 전이나 공간적으로 상관된 미관측 요인을 충분히 반영하기 어렵다. 이에 본 연구는 주택 가격의 공간적 의존성을 추가로 점검하기 위하여 공간 시차 모형(Spatial Lag Model, SLM)과 공간 오차 모형(Spatial Error Model, SEM)을 함께 검토하였다(LeSage and Pace, 2009; Elhorst, 2013).
공간 시차 모형(SLM)은 인접 지역의 주택 가격 수준(Wy)이 해당 지역의 주택 가격에 직접적인 영향을 미친다는 가정을 반영한다. 이는 인접 지역 간 가격 정보의 확산이나 대체 관계에 따른 공간적 연동을 모형화한 것이다. 반면 공간 오차 모형(SEM)은 관측되지 않은 입지적·환경적 요인이나 외생적 충격이 오차항을 통해 공간적으로 상관될 수 있음을 가정한다. 다시 말해 SLM은 가격의 직접적 전이 가능성에, SEM은 누락된 요인의 공간적 공유 가능성에 각각 초점을 둔다.
본 연구에서는 Moran’s I와 LISA를 통해 서울 주택가격의 공간 군집을 먼저 확인한 뒤, 공식 공간경계 자료를 바탕으로 구축한 Queen contiguity 공간가중행렬을 사용하여 연도별 SLM과 SEM을 추가적으로 점검하였다. 이를 통해 범죄율과 고용 중심성 변수를 포함한 모형에서 공간적 의존성이 어떠한 방식으로 나타나는지를 점검하고, 고정효과 모형의 결과가 공간구조를 고려한 이후에도 대체로 유지되는지를 보완적으로 점검하고자 하였다. 다만 공간모형은 인과효과를 식별하기 위한 장치라기보다, 공간적 상호작용과 공간적으로 공유되는 미관측 요인을 보다 적절하게 반영하기 위한 보완적 분석틀로 해석하였다.
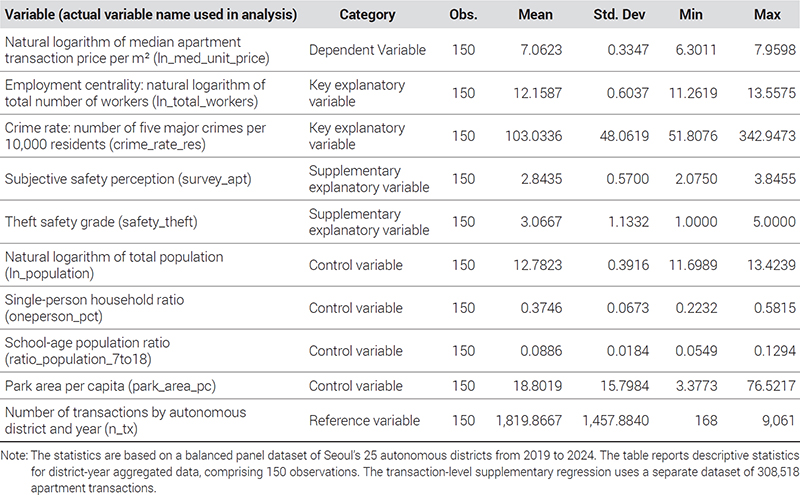
<Table 2>에는 최종 분석에 실제 사용된 변수의 기술통계량을 제시하였다. 핵심 설명변수는 crime_rate_res와 ln_total_workers이며, 보조 설명변수로는 safety_theft와 survey_apt를 포함하였다. 기술통계량은 서울시 25개 자치구의 2019-2024년 균형 패널 자료(150개 관측치)를 기준으로 산출하였으며, 범죄 변수는 5대 범죄 발생 건수가 아니라 인구 1만 명당 범죄율을 사용하였다.
Descriptive statistics of key variables based on district-year aggregated data
이중 고정효과 모형의 표준오차는 자치구 단위의 군집화를 반영하여 추정하였다. 이는 동일 자치구 내에서 시계열적으로 상관될 수 있는 오차 구조를 고려하기 위한 것이다. 공간 모형은 최대우도추정법(Maximum Likelihood Estimation)을 이용하여 추정하였다. 거래단위 고정효과 회귀는 308,518건의 거래자료를 기반으로 추정하였으며, 자치구-연도 집계모형은 150개 관측치를 이용한 보조 분석으로 제시하였다. 이에 따라 본문의 핵심 계수 해석은 거래단위 결과를 중심으로 하고, 집계모형과 공간진단은 결과의 방향성과 공간구조를 점검하는 보완적 근거로 활용하였다.
아울러 본 연구는 결과의 강건성을 점검하기 위하여 몇 가지 추가 분석을 수행하였다. 첫째, 범죄율의 분모를 거주인구 기준뿐 아니라 활동인구 및 종사자 수 기준으로 대체하여 결과의 민감도를 확인하였다. 둘째, 자치구별 선형추세를 추가한 모형을 통해 자치구마다 상이한 시간적 변화를 부분적으로 통제하였다. 셋째, 고용 중심성 수준에 따른 분위별 분석과 특정 자치구를 하나씩 제외하는 leave-one-out 분석을 통해 결과가 일부 지역에 의해 좌우되는지 여부를 점검하였다. 이러한 추가 분석은 범죄율과 고용 중심성 간의 관계를 보다 신중하게 해석하기 위한 보완 절차로 활용하였다.
Ⅳ. 분석결과
1. 기술통계 및 변수의 기초적 특성
본격적인 계량 분석에 앞서, 본 연구에서 사용한 주요 변수들의 분포 특성과 변동성을 확인하였다. <Table 2>는 2019년부터 2024년까지 서울시 25개 자치구를 대상으로 구축한 자치구-연도 균형 패널 자료(N = 150)의 기술통계량을 제시한다. 이는 공간 진단과 집계 수준 분석의 기초 자료이며, 이후 핵심 회귀분석에서는 거래단위 자료 308,518건을 활용한 고정효과 모형을 함께 제시하여 집계자료의 표본 한계를 보완하였다.
종속변수인 자치구별 아파트 m2당 중위 실거래가격의 자연로그값(ln(Pit))은 평균 7.0623, 표준편차 0.3347로 나타났으며, 최솟값은 6.3011, 최댓값은 7.9598로 확인되었다. 이는 동일한 시점에서도 자치구 간 주택가격수준의 차이가 상당함을 의미하며, 서울 주택시장이 공간적으로 균질하지 않고 뚜렷한 가격 격차를 내포하고 있음을 보여준다.
본 연구의 핵심 설명변수 가운데 고용 중심성을 대리하는 ln_total_workers는 평균 12.1587, 표준편차 0.6037로 나타났다. 최솟값은 11.2619, 최댓값은 13.5575로, 서울시 자치구별 경제적 밀도와 중심지 기능의 위상이 상당한 차이를 보이고 있음을 확인할 수 있다. 이는 강남구, 중구, 영등포구와 같은 상업·업무 중심지와 외곽 주거 중심 자치구 사이의 구조적 차이를 반영하는 것으로 볼 수 있다.
또 다른 핵심 변수인 범죄율(crime_rate_res)은 인구 1만 명당 5대 범죄 발생 건수로 측정하였다. 그 평균은 103.0336건, 표준편차는 48.0619로 나타났으며, 최소값은 51.8076, 최대값은 342.9473이었다. 이는 서울 내부에서도 객관적 범죄 노출 수준의 편차가 상당히 크다는 점을 보여준다. 특히 상업·업무 기능이 집중된 도심 및 부도심 지역과 주거 기능이 중심이 되는 외곽 지역 사이에서 범죄 노출 수준의 차이가 뚜렷하게 나타난다는 점은, 범죄 지표가 단순한 위험 변수에 그치지 않고 대도시의 공간적 기능 배치와도 밀접하게 연관될 수 있음을 시사한다.
행정안전부 생활안전지도를 기반으로 한 사회안전지표 역시 자치구 간에 적지 않은 편차를 보였다. 절도 안전등급(safety_theft)은 동일한 도시 내부에서도 생활 안전 환경에 상당한 차이가 존재함을 보여준다. 이러한 결과는 안전을 단일한 개념으로 보기보다 위험 유형별로 구분하여 살펴볼 필요가 있음을 뒷받침한다.
통제변수의 경우, 1인 가구 비율은 평균 0.3746으로 나타나 서울시의 인구·가구 구조가 이미 단독 가구 중심으로 재편되어 있음을 보여준다. 학령인구(7-18세) 비율은 평균 0.0886으로 비교적 낮은 수준을 보였으며, 1인당 공원면적 역시 최소 3.3773m2에서 최대 76.5217m2까지 넓은 범위를 보여 생활환경 여건의 공간적 불균형이 존재함을 확인할 수 있다.
<Figure 1>은 2024년 기준 자치구별 아파트 가격의 공간적 분포를 보여준다. 강남·서초·송파를 중심으로 한 동남권과 한강변 주요 지역을 중심으로 고가 주택지대가 뚜렷하게 형성되어 있음을 시각적으로 확인할 수 있다. 이러한 분포는 서울 주택시장이 무작위적으로 형성된 것이 아니라 특정 지역을 중심으로 가격이 응집되는 구조를 가진다는 점을 시사한다.
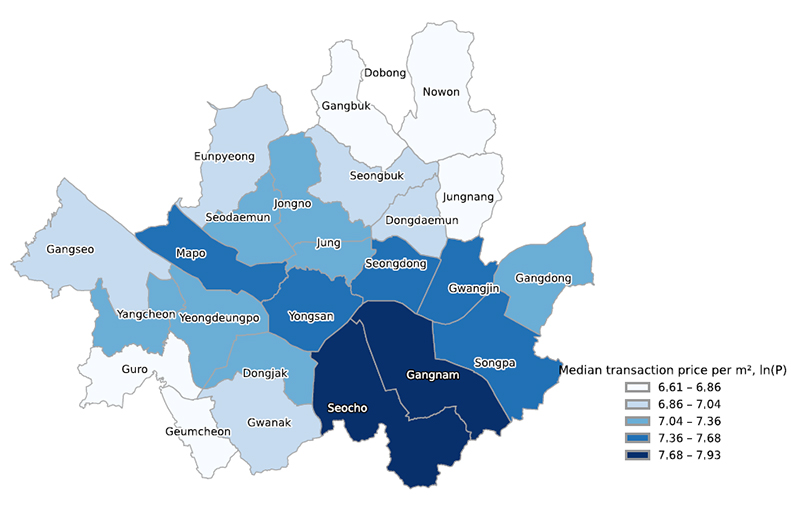
Spatial distribution of median apartment transaction prices per square meter by autonomous district in Seoul, 2024Note: The figure visualizes the natural logarithm of the median apartment transaction price per square meter by autonomous district in 2024 using the shapefile provided by the Statistical Geographic Information Service. Darker blue indicates a higher price level. High-price areas are mainly concentrated in the three Gangnam districts and along the Han River.
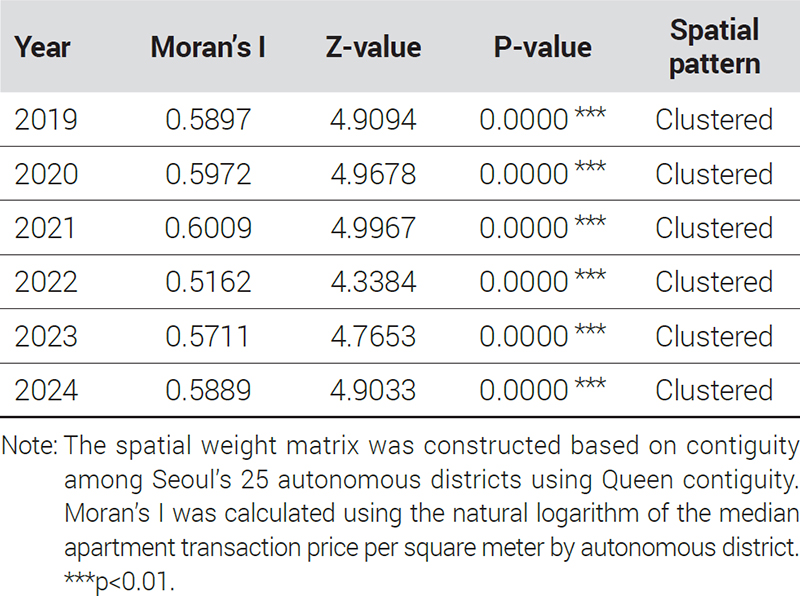
<Table 3>의 Moran’s I 분석 결과 역시 이러한 공간 군집 구조를 뒷받침한다. 2019년부터 2024년까지 모든 연도에서 Moran’s I 값은 0.5162에서 0.6009 사이로 나타났으며, 모두 통계적으로 유의하였다. 이는 서울 자치구별 주택가격이 강한 양(+)의 공간적 자기상관을 보인다는 뜻으로, 고가 지역은 인접한 고가 지역과, 저가 지역은 인접한 저가 지역과 군집하는 경향이 지속적으로 유지되고 있음을 의미한다. 이러한 결과는 서울 주택시장을 분석할 때 공간적 의존성을 명시적으로 고려할 필요가 있음을 보여주는 직접적인 근거가 된다.
Annual Moran’s I indices and test statistics for housing prices
<Figure 2>는 객관적 범죄 노출과 안전 관련 지표가 반드시 동일한 공간 분포를 보이지 않음을 보여준다. 5대 범죄 발생 건수 지도에서는 강남, 영등포 등 상업·업무 기능이 집중된 지역에서 범죄 노출이 높은 경향이 나타나는 반면, 절도 안전등급 분포에서는 양천구, 도봉구, 성북구, 노원구 등 주거 기능이 상대적으로 강한 지역에서 높은 안전 수준이 관찰된다. 이러한 공간적 불일치는 객관적 범죄 위험과 안전 관련 지표가 서로 다른 차원을 반영할 수 있음을 시사한다. 따라서 서울 주택시장에서 범죄와 안전의 관계는 하나의 단일 지표만으로 설명되기보다, 객관적 위험과 제도적 안전지표가 서로 다른 방식으로 작동하는 구조로 이해할 필요가 있다.
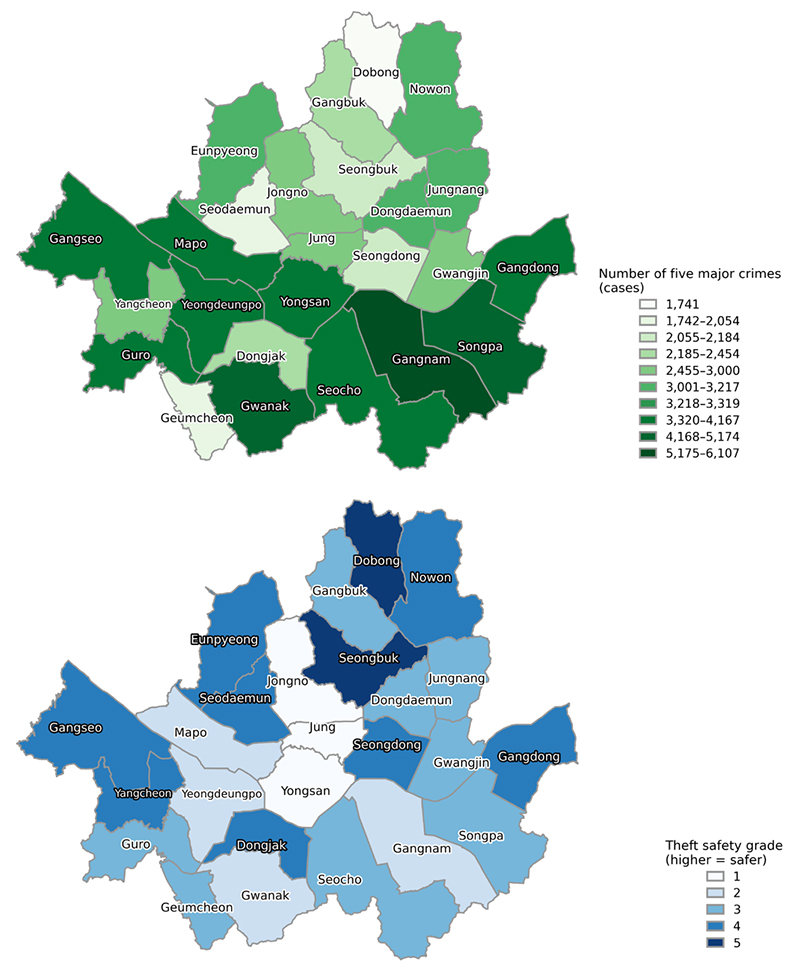
Comparison of five-major-crime counts and theft safety grades by autonomous districtNote: The left map presents the distribution of the number of five major crimes (cases). The right map presents the distribution of theft safety grades based on the Life Safety Map provided by the Ministry of the Interior and Safety.
2. 주택가격의 공간적 자기상관 진단
주택가격이 공간적으로 독립적인지, 아니면 인접 지역과의 상호작용 속에서 군집을 이루며 형성되는지를 확인하기 위해 전역적 및 국지적 공간 자기상관 분석을 수행하였다. 구체적으로는 공식 공간경계 자료를 바탕으로 구축한 서울시 25개 자치구의 Queen contiguity 공간가중행렬을 적용하여 Moran’s I 검정과 Local Indicators of Spatial Association(LISA) 분석을 실시하였다.
<Table 3>은 2019년부터 2024년까지 서울시 자치구별 아파트 m2당 중위 실거래가격의 자연로그값에 대해 산출한 연도별 Moran’s I 통계량과 검정 결과를 제시한다. 분석 결과, 전 기간에 걸쳐 Moran’s I 값은 0.5162에서 0.6009 사이의 비교적 높은 수준을 유지하였으며, 모든 연도에서 통계적으로 유의한 양(+)의 공간적 자기상관이 확인되었다. 이는 서울시 주택가격이 무작위적으로 분포하지 않고, 고가 지역은 고가 지역과, 저가 지역은 저가 지역과 인접하여 분포하는 공간 군집 구조를 갖고 있음을 의미한다.
연도별 Moran’s I 값이 분석 기간 전체에 걸쳐 일관되게 양(+)의 값을 유지한다는 점은 서울 주택시장의 공간적 군집이 특정 시점의 우연한 현상에 그치지 않음을 보여준다. 물론 연도별 수치에는 다소 차이가 있으나, 전 기간에 걸쳐 공간적 자기상관이 반복적으로 확인된다는 사실은 주택가격 분석에서 공간적 의존성을 명시적으로 고려할 필요가 있음을 뒷받침한다. 다시 말해, 주택가격은 개별 자치구의 특성만으로 형성되기보다 인접 지역의 가격 수준과 공간적 맥락 속에서 함께 움직일 가능성이 크다.
전역적 자기상관 분석의 한계를 보완하기 위해 수행한 LISA 분석 결과(Figure 3)를 보면, 강남·서초·송파를 중심으로 한 동남권에서 일관된 고가-고가(High-High) 군집이 형성되어 있음을 확인할 수 있다. 반면 일부 외곽 자치구에서는 저가-저가(Low-Low) 군집이 반복적으로 관찰되어, 서울 주택시장이 뚜렷한 공간적 이질성을 내포하고 있음을 보여준다. 이러한 국지적 군집 패턴은 주택가격이 개별 자치구의 속성만으로 설명되기 어렵고, 인접 지역과의 상호작용 속에서 형성되고 있음을 시각적으로 보여준다.
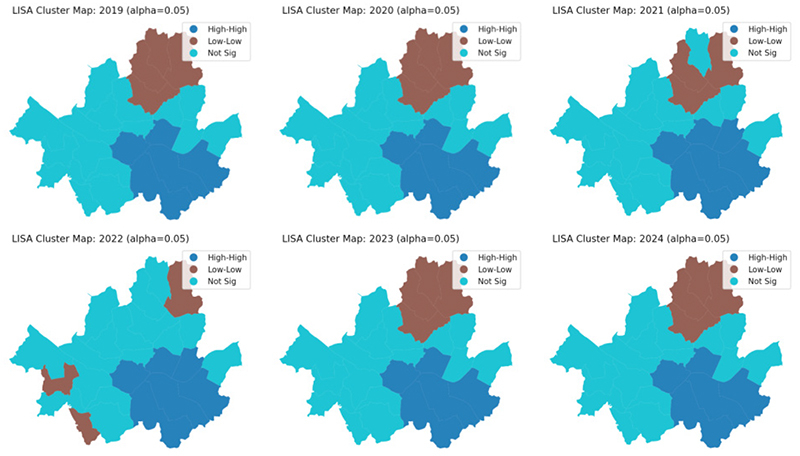
Local Indicators of Spatial Association (LISA) analysis of apartment prices by autonomous district in Seoul, 2019–2024Note: This figure presents the results of the LISA analysis for the natural logarithm of the median apartment transaction price per square meter by autonomous district from 2019 to 2024. Using a Queen contiguity-based spatial weight matrix, a stable High–High cluster centered on Gangnam, Seocho, and Songpa is consistently observed throughout the study period, while Low–Low clusters repeatedly appear in several peripheral districts. These findings suggest that the spatial clustering of housing prices in Seoul reflects a structural characteristic rather than a short-term fluctuation.
3. 패널 회귀분석 결과: 기본 모형과 강건성 검정
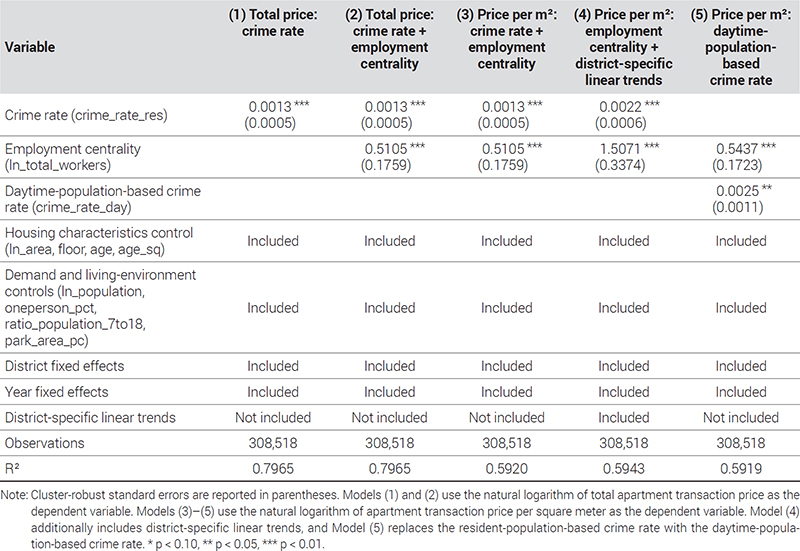
공간적 자기상관 진단 결과를 바탕으로, 본 절에서는 범죄율과 고용 중심성이 주택가격과 어떠한 관련성을 보이는지를 비교하였다. 본문의 핵심 계수 해석은 거래단위 자료 308,518건을 이용한 고정효과 회귀 결과를 중심으로 하며, 자치구-연도 집계모형은 결과의 방향성과 강건성을 보완적으로 점검하기 위해 함께 제시한다. 특히 <Table 4>에서는 기본 총가격 모형, 고용 중심성을 포함한 확장 모형, 단위면적 가격을 종속변수로 한 강건성 모형, 자치구별 선형추세를 추가한 모형, 그리고 활동인구 기준 범죄율을 사용한 대체 모형을 순차적으로 제시함으로써, 범죄율과 주택가격의 관계가 고용 중심성 통제 이후에도 유지되는지를 살펴보았다.
Transaction-level fixed-effects regression results: Baseline models and robustness checks
분석 결과, 거래단위 기본 모형에서 범죄율(crime_rate_res)은 주택가격과 통계적으로 유의한 양(+)의 관련성을 보였다. 이어서 고용 중심성을 나타내는 ln_total_workers를 포함한 확장 모형에서도 범죄율의 유의성은 유지되었고, ln_total_workers 역시 유의한 양(+)의 계수를 나타냈다. 이는 서울 주택시장에서 범죄율과 고용 중심성이 서로 대체적인 설명요인으로 작동한다기보다, 중심지 특성이 강한 지역에서 함께 관찰되는 요인일 가능성을 시사한다. 다시 말해, 범죄와 주택가격 간에 관찰되는 양(+)의 관계를 단순히 고용 중심성의 누락에 따른 통계적 착시로 환원하기는 어렵다. 오히려 높은 가격, 높은 고용 중심성, 그리고 높은 범죄 노출이 동일한 도시공간에 함께 응축되어 나타나는 대도시의 복합적 구조로 이해할 필요가 있다. 거래단위 결과에서 범죄율은 crime_rate_res 기준으로 유의하였고, 활동인구를 분모로 한 crime_rate_day를 사용한 경우에도 양(+)의 계수가 유지되었다. 또한 ln_total_workers는 확장 모형과 자치구별 선형추세를 포함한 모형 모두에서 안정적으로 유의한 양(+)의 계수를 보였다.
단위면적 가격을 종속변수로 사용한 추가 모형에서도 결과의 방향은 본질적으로 달라지지 않았다. 범죄율과 ln_total_workers는 모두 양(+)의 계수를 유지하였고, 자치구별 선형추세를 추가한 모형에서도 이러한 관계는 여전히 유의하게 나타났다. 이는 범죄율과 고용 중심성의 관련성이 단순히 총가격 수준이나 자치구별 추세 차이에 의해 발생한 결과만은 아니라는 점을 보여준다. 또한 범죄율의 분모를 거주인구 기준에서 활동인구 기준으로 변경한 경우에도 계수의 방향은 유지되었다. 이러한 결과는 서울 주택시장에서 범죄 노출과 고용 중심성이 모두 주택가격과 연관되어 있음을 반복적으로 확인해준다.
이러한 결과는 대도시 주택시장에서 높은 범죄 노출이 곧바로 낮은 가격으로 이어진다고 보기 어렵다는 점을 보여준다. 동시에 높은 주택가격이 범죄 위험에 대한 선호를 의미한다고 해석하는 것도 적절하지 않다. 보다 타당한 해석은, 상업 및 업무 기능이 집중된 중심지일수록 높은 접근성과 고용 편익, 높은 가격, 그리고 높은 범죄 노출이 함께 나타날 수 있으며, 주택시장은 이러한 도시공간의 복합적 구조를 반영한다는 것이다. 따라서 서울 주택시장에서 범죄와 가격의 관계는 단일한 방향의 인과관계라기보다, 중심지의 경제적 집적과 공간적 의존성을 함께 고려한 맥락 속에서 이해될 필요가 있다.
4. 고용 중심성 수준에 따른 이질성 검토
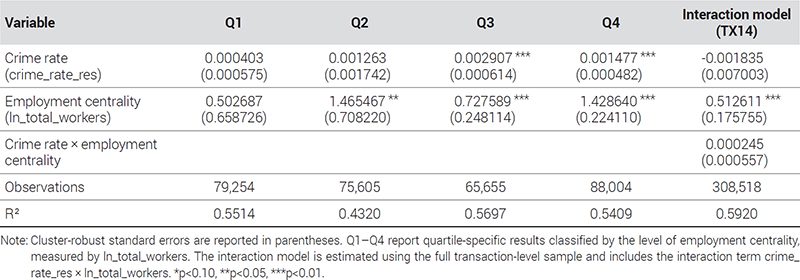
범죄율과 고용 중심성의 관계가 서울시 모든 지역에서 동일하게 나타나는지 확인하기 위해, 보완적 성격의 추가 분석으로 거래단위 표본을 고용 중심성 수준에 따라 분위별로 구분하였다. <Table 5>는 그 결과를 제시한다. 분석 결과, 고용 중심성 수준이 가장 낮은 분위(Q1)에서는 범죄율과 ln_total_workers 모두 통계적으로 유의하지 않았다. 반면 Q2에서는 범죄율의 계수는 유의하지 않았으나 ln_total_workers는 유의한 양(+)의 계수를 나타냈다. 고용 중심성 수준이 상대적으로 높은 분위(Q3, Q4)에서는 범죄율과 ln_total_workers가 모두 주택가격과 유의한 양(+)의 관련성을 보였다. 이는 범죄율과 주택가격의 양(+) 관계가 모든 공간에서 동일하게 나타난다기보다, 중심지 기능과 경제활동 집적이 상대적으로 강한 지역에서 더 뚜렷하게 관찰될 수 있음을 시사한다.
Heterogeneity analysis by level of employment centrality
다만 전체 거래단위 표본을 대상으로 한 상호작용 모형에서는 범죄율과 고용 중심성의 상호작용항(crime_rate_res×ln_total_workers)이 통계적으로 유의하지 않았다. 따라서 고용 중심성이 범죄효과를 직접적으로 증폭하거나 완화한다고 단정하기는 어렵다. 보다 적절한 해석은, 서울 대도시 공간에서 고용 중심성이 높은 지역일수록 높은 가격, 높은 경제활동, 그리고 높은 범죄 노출이 함께 나타날 가능성이 크다는 것이다. 이러한 결과는 범죄율과 주택가격의 관계를 단순한 위험 선호나 하나의 누락변수 문제로 환원하기보다, 중심지의 복합적 공간구조 속에서 이해할 필요가 있음을 보여준다.
5. 공간 모형을 통한 추가 점검 결과: 공간시차 효과와 공간오차 효과의 비교
앞선 Moran’s I 및 LISA 분석 결과, 서울시 주택가격은 분석 기간 전반에 걸쳐 강한 공간적 자기상관을 보이는 것으로 확인되었다. 이에 본 절에서는 이러한 공간적 의존성을 보다 명시적으로 살펴보고, 기본 회귀모형의 결과가 공간구조를 고려한 이후에도 대체로 유지되는지를 보완적으로 확인하기 위해 공간시차모형(Spatial Lag Model, SLM)과 공간오차모형(Spatial Error Model, SEM)을 추가적으로 검토하였다. 공간진단은 공식 공간 경계 자료를 바탕으로 구축한 서울시 25개 자치구의 Queen contiguity 공간가중행렬을 사용하여 수행하였다.
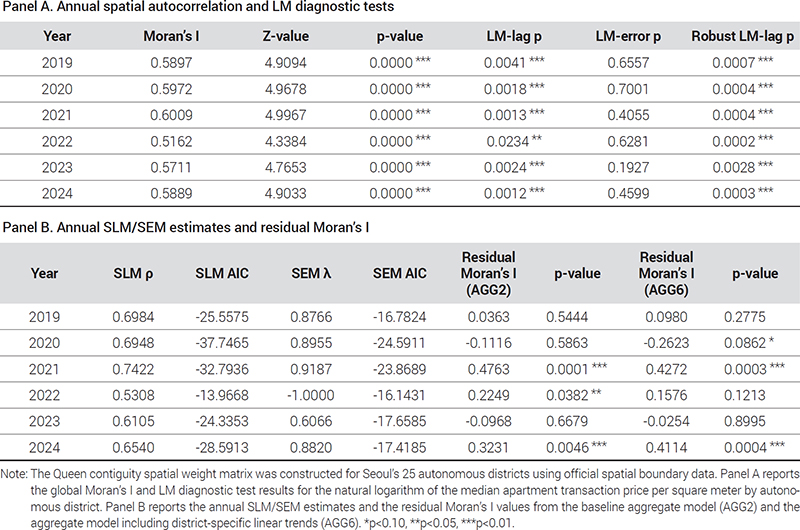
<Table 6>에 제시된 분석 결과를 보면, 연도별 Moran’s I는 2019년부터 2024년까지 0.5162~0.6009의 범위에서 모두 통계적으로 유의하게 나타나 서울 주택가격이 강한 양(+)의 공간적 군집 구조를 보인다는 점을 다시 확인할 수 있다. 이어서 수행한 연도별 공간진단에서는 LM-lag와 robust LM-lag 통계량이 전반적으로 유의하게 나타난 반면, LM-error는 대부분 유의하지 않거나 상대적으로 약한 수준에 머물렀다. 이는 서울 주택시장의 공간의존성이 단순한 공간오차 구조에만 기인한다기보다, 인접 지역 가격의 연동과 같은 공간시차 구조와 더 밀접하게 관련될 가능성을 시사한다.
Spatial diagnostic tests and additional SLM/SEM results based on Queen contiguity
공간모형의 추정 결과도 이와 유사한 방향을 보였다. 공식 Queen contiguity 기반 연도별 SLM 추정에서 공간시차계수 ρ는 0.5308~0.7422의 범위로 나타나 모두 안정성 조건 |ρ|<1을 충족하였다. 또한 대부분의 연도에서 SLM의 AIC가 SEM보다 더 낮게 나타나, 적어도 본 연구의 공간가중행렬 설정 아래에서는 공간시차모형이 상대적으로 더 적합한 설명력을 보이는 것으로 해석할 수 있었다. 반면 SEM의 공간오차계수 λ는 대체로 양(+)의 값을 보였으나, 2022년에는 경곗값에 가까운 추정치가 나타나는 등 연도별 안정성이 다소 일관되지 않았다. 이러한 결과는 서울 주택시장에서 공간적 의존성이 존재한다는 사실 자체는 분명하지만, 그 양상은 공간오차 효과보다 공간시차 효과가 상대적으로 우세한 방향으로 나타날 가능성이 크다는 점을 시사한다. 따라서 이 절의 공간모형 결과는 주된 식별 근거라기보다, 기본 회귀결과의 방향성과 공간의존성의 유형을 확인하기 위한 추가 진단으로 해석한다.
다만 공간모형이 모든 공간적 문제를 완전히 제거한 것은 아니었다. 기본 집계모형(AGG2)과 자치구별 선형추세를 포함한 모형(AGG6)의 잔차에 대해 추가로 Moran’s I를 산출한 결과, 2021년에는 두 모형 모두에서 잔차 공간상관이 강하게 유의하게 남아 있었고, AGG2 모형에서는 2022년과 2024년에도 유의한 잔차 공간상관이 확인되었다. AGG6 모형의 경우 2024년에는 유의한 잔차 공간상관이 남아 있었고, 2020년에는 약한 수준의 유의성을 보였다. 이는 공간적 자기상관을 고려한 이후에도 서울 주택시장의 공간구조를 완전히 설명하기는 어렵다는 뜻이며, 공간모형 결과 역시 강한 인과적 결론의 근거라기보다 기본 회귀결과를 보완적으로 점검하는 장치로 해석할 필요가 있음을 보여준다.
종합하면, 공식 Queen contiguity 기반 추가 진단은 서울 주택시장에서 강한 공간적 군집이 존재함을 다시 확인해주며, 그 공간의존성은 공간오차 구조보다 공간시차 구조와 더 밀접하게 연결될 가능성을 보여준다. 동시에 거래단위 및 자치구-연도 수준의 기본 분석에서 확인된 범죄율과 고용 중심성의 양(+)의 관련성은 이러한 공간 점검 이후에도 크게 흔들리지 않았다. 따라서 서울 주택시장에서 범죄율과 주택가격의 양(+)의 관계는 단순한 모형 설정만으로 설명되기보다, 중심지의 경제적 집적과 공간적 연동 속에서 함께 관찰되는 대도시 주택시장의 복합적 구조로 이해할 필요가 있다.
V. 결론 및 논의
1. 연구 결과의 요약
본 연구는 2019년부터 2024년까지 서울시 25개 자치구를 대상으로, 주택가격과 범죄 및 안전 요인 간의 관계를 공간적 관점을 포함하여 실증적으로 분석하였다. 특히 범죄율과 주택가격간에 관찰되는 관계를 고용 중심성 및 중심지 기능의 맥락에서 재검토하고, 이 관계가 공간적 의존성을 고려한 이후에도 어떠한 양상으로 나타나는지를 살펴보는 데 초점을 두었다. 이때 기본 공간 진단과 자치구-연도 수준 분석은 150개 관측치의 균형 패널 자료를 이용하였고, 핵심 계수 해석은 거래단위 자료 308,518건을 이용한 추가 고정효과 회귀를 중심으로 정리하였다.
주요 분석 결과는 다음과 같다. 첫째, 서울시 아파트 가격은 전 기간에 걸쳐 강한 공간적 군집 특성을 보였다. 공식 공간경계 자료를 바탕으로 구축한 Queen contiguity 공간가중행렬을 적용한 결과, 연도별 Moran’s I는 0.5162에서 0.6009 사이의 높은 양(+)의 값을 나타냈으며 모든 연도에서 통계적으로 유의하였다. 이는 서울 주택가격이 개별 자치구의 독립적 속성만으로 형성되기보다, 인접 지역과 공유되는 입지적·경제적 조건 속에서 상호 연동적으로 형성된다는 점을 보여준다.
둘째, 범죄율과 고용 중심성은 모두 주택가격과 유의한 양(+)의 관련성을 보였다. 거래단위 추가 분석과 자치구-연도 집계 분석을 모두 고려하더라도, 범죄율의 양(+)의 계수는 고용 중심성을 나타내는 종사자 수 변수를 통제한 이후에도 대체로 유지되었으며, 종사자 수 역시 안정적으로 양(+)의 관련성을 나타냈다. 이는 범죄와 주택가격의 양(+)의 관계를 단순히 고용 중심성 누락에 따른 통계적 착시로 환원하기 어렵다는 뜻이다. 오히려 서울의 중심지적 특성이 강한 지역에서는 높은 주택가격, 높은 경제활동 집적, 그리고 높은 범죄 노출이 함께 관찰될 가능성이 크다는 점이 보다 설득력 있게 드러났다.
셋째, 고용 중심성 수준에 따른 추가 분석에서는 이러한 관계가 모든 공간에서 동일하게 나타나지 않음을 확인하였다. 고용 중심성 수준이 낮은 분위에서는 범죄율의 계수가 유의하지 않았던 반면, 중상위 분위에서는 범죄율과 종사자 수가 모두 유의한 양(+)의 관련성을 보였다. 반면 범죄율과 고용 중심성의 상호작용항은 통계적으로 유의하지 않아, 고용 중심성이 범죄효과를 직접 증폭하거나 약화시킨다고 단정하기는 어려웠다. 이러한 결과는 서울 주택시장에서 범죄율과 가격의 관계가 단순한 선호 구조라기보다, 중심지의 집적과 접근성이 상대적으로 강한 공간에서 더 뚜렷하게 관찰되는 복합적 현상임을 시사한다.
2. 학술적 기여 및 논의
본 연구의 학술적 기여는 다음과 같다. 첫째, 범죄와 주택가격의 관계를 대도시 중심지 구조의 맥락에서 재해석하였다는 점이다. 기존 문헌이 범죄를 주로 부정적 외부효과로 다루어 왔다면, 본 연구는 서울과 같은 고밀도 대도시에서 범죄 노출이 고용 중심성, 상업 집적, 접근성과 함께 나타날 수 있다는 가능성을 실증적으로 검토하였다. 이를 통해 범죄와 주택가격의 양(+) 관계를 단순한 위험 선호나 단일 변수의 효과로 보기보다, 대도시 공간구조 속에서 여러 속성이 함께 응축되어 나타나는 현상으로 해석할 필요가 있음을 제시하였다.
둘째, 공간적 의존성과 시간적 변동을 함께 고려하는 분석틀을 적용함으로써 서울 주택시장의 구조를 보다 정교하게 살펴보았다는 점이다. 공식 Queen contiguity 기반 추가 점검에서 서울 주택가격의 강한 공간자기상관이 다시 확인되었고, 연도별 공간진단에서는 공간오차 구조보다 공간시차 효과가 상대적으로 우세한 경향도 나타났다. 다만 일부 연도에서는 잔차 공간상관이 남아 있어 공간모형의 해석 역시 보조적 점검의 수준에서 신중하게 다루어야 함을 확인하였다. 이러한 결과는 서울 주택가격을 설명할 때 공간구조를 단순한 부가적 요소가 아니라 핵심 조건으로 고려할 필요가 있음을 보여준다.
셋째, 객관적 범죄지표와 사회안전 관련 지표를 함께 검토함으로써 대도시 주택시장에서 안전의 개념이 단일하지 않다는 점을 보여주었다. 추가 분석에서는 주관적 안전인식 변수의 설명력이 제한적인 반면, 절도 안전지표와 같은 일부 객관적 안전변수는 통계적으로 유의한 관련성을 보였으며, 지도 비교에서는 객관적 범죄 노출과 주민의 체감 안전이 반드시 동일한 공간 분포를 보이지 않음을 확인할 수 있었다. 이는 서울 주택시장에서 안전과 가격의 관계를 하나의 단일 척도로 환원하기 어렵다는 점을 시사한다.
3. 정책적 시사점
본 연구의 결과는 도시 정책과 안전 정책에 몇 가지 시사점을 제공한다. 첫째, 서울의 중심지적 특성이 상대적으로 강한 지역에서는 높은 주택가격과 높은 경제활동 집적, 그리고 높은 범죄 노출이 함께 관찰될 가능성이 크다는 점에서, 주거정책과 안전정책은 서로 분리된 영역으로 접근되기보다 통합적으로 설계될 필요가 있다. 특히 상업·업무 기능이 집중된 지역에서는 유동인구와 경제활동의 밀도가 높은 만큼, 전통적 의미의 치안 강화뿐 아니라 보행환경 개선, 생활권 단위의 범죄예방환경설계(CPTED), 지능형 감시 인프라 구축과 같은 공간기반 대응이 병행될 필요가 있다.
둘째, 서울 내부에서도 고용 중심성 수준에 따라 범죄율과 주택가격의 관계가 다르게 나타났다는 점에서, 지역별 여건을 고려한 차별적 접근이 요구된다. 중심지 기능이 강한 지역에서는 범죄 노출을 줄이는 동시에 경제활동과 접근성의 장점을 유지할 수 있는 정밀한 정책 설계가 중요하다. 반면 주거기능이 상대적으로 강한 지역에서는 범죄율보다 생활환경의 안정성, 공원과 같은 어메니티, 교육 및 주거 쾌적성의 개선이 주민 복지와 주택시장 안정에 더 직접적인 영향을 미칠 수 있다.
셋째, 안전과 가격의 관계를 해석할 때 객관적 범죄통계와 주민의 주관적 안전인식을 함께 고려할 필요가 있다. 본 연구는 두 지표가 항상 같은 공간 분포를 보이지 않음을 보여주었기 때문에, 정책 수립 과정에서도 실제 범죄 노출 수준과 주민 체감 안전을 동시에 반영하는 복합적 접근이 요구된다.
4. 연구의 한계 및 향후 연구 과제
본 연구는 다음과 같은 한계를 지니며, 후속 연구를 통해 보완될 필요가 있다. 첫째, 본 연구는 분석 단위를 자치구 수준으로 설정하여 서울 전역의 구조적 관계를 파악하는 데 초점을 두었으나, 그로 인해 동 단위나 개별 단지 수준에서 나타나는 미시적 이질성을 충분히 포착하지 못하였다. 향후 연구에서는 보다 세분화된 공간 단위를 활용하여 근린 환경과 국지적 범죄 노출이 주택가격에 미치는 영향을 보다 정밀하게 검토할 필요가 있다.
둘째, 본 연구는 고용 중심성의 대리변수로 총종사자 수를 사용하였다. 이는 중심지 기능과 경제활동 집적을 반영한다는 장점이 있지만, 경제 중심지 특성의 모든 차원을 포괄하는 것은 아니다. 향후 연구에서는 고용 밀도, 사업체 밀도, 유동인구, 토지이용 혼합도와 같은 대안적 지표를 활용하여 중심지 특성을 보다 다차원적으로 측정할 필요가 있다.
또한 본 연구는 자치구 고정효과를 통해 시간불변 지역 특성의 상당 부분을 통제하였으나, 중심업무지구 접근성, 한강 수변 프리미엄, 강남·강북의 지역 위계와 같은 핵심 입지요인을 직접 변수로 측정하여 포함하지는 못하였다. 이러한 요인들은 자치구 수준에서는 대체로 시간에 따라 크게 변하지 않기 때문에, 고정효과 모형에서는 별도의 계수로 식별되기 어렵다는 점도 함께 고려할 필요가 있다. 아울러 고용 중심성과 사업체 수 변수는 서로 높은 상관을 보여 동일 모형에 동시에 포함할 경우 다중공선성 문제가 발생할 수 있었으므로, 본 연구에서는 이를 대체적 강건성 모형으로 분리하여 검토하였다.
셋째, 본 연구는 범죄율을 5대 범죄의 합계를 바탕으로 구성하였다. 그러나 강력범죄와 생활범죄는 발생 원인과 공간적 분포, 그리고 주택가격에 미치는 영향 경로가 다를 수 있다. 후속 연구에서는 범죄 유형을 보다 세분화하여, 중심지의 집적과 함께 나타나는 범죄와 순수한 주거 위험으로서의 범죄를 구분해볼 필요가 있다.
넷째, 본 연구는 고정효과 모형과 공간모형을 통해 범죄율과 고용 중심성, 주택가격 간의 관계를 비교적 엄밀하게 검토하였지만, 자연실험이나 도구변수 접근과 같은 강한 인과 식별 설계를 사용한 것은 아니다. 따라서 본 연구의 결과는 인과효과를 단정하기보다, 서울 대도시 공간에서 반복적으로 관찰되는 연관성의 구조를 보여주는 실증적 근거로 이해할 필요가 있다.
다섯째, 본 연구는 아파트 시장을 중심으로 분석을 수행하였다. 그러나 다세대·다가구 주택이나 임대 중심 주거형태에서는 범죄와 고용 중심성의 관계가 다르게 나타날 가능성이 있다. 향후 연구에서는 주택 유형별·거주 계층별 비교를 통해, 대도시 주거 불평등과 안전 문제를 보다 세밀하게 검토할 필요가 있다.
References
-
김갑열·김윤옥, 2017. “주거환경의 안전 결정요인에 관한 연구: 서울시 공동주택을 중심으로”, 「부동산학보」, 71: 207-231.
Kim, G.Y. and Kim, Y.O., 2017. “A Study on the Determinants of Safety of Residential Environment – Focused on the Apartment House in Seoul –”, Korea Real Estate Academy Review, 71: 207-231. -
김연미, 2008. “서울시 아파트가격 불균등에 관한 공간통계적 분석”, 「지리학논총」, 52: 17-47.
Kim, Y.M., 2008. “Spatial Statistical Analysis of Apartment Price Inequality in Seoul”, Journal of Geography, 52: 17-47. -
김지영·김은정, 2019. “서울시 아파트단지의 지역별 근린환경 비교”, 「부동산분석」, 5(1): 77-94.
Kim, J.Y. and Kim, E.J., 2019. “A Comparison of Neighborhood Environments of Apartment Complexes across Districts in Seoul”, Journal of Real Estate Analysis, 5(1): 77-94. [https://doi.org/10.30902/jrea.2019.5.1.77]
-
나은지·고동원·박승훈, 2024. “보행안전이 아파트 가격에 미치는 영향: 공간헤도닉모형을 활용하여”, 「부동산분석」, 10(3): 117-134.
Na, E.J., Ko, D.W., and Park, S.H., 2024. “The Impact of Pedestrian Safety on Apartment Prices: Using Spatial Hedonic Model”, Journal of Real Estate Analysis, 10(3): 117-134. [https://doi.org/10.30902/jrea.2024.10.3.117]
-
이윤상·오민준·고영화, 2022. 「주택가격의 공간적 분포와 주택가격에 의한 주거지 분리 현상에 관한 연구: 5개 대도시를 중심으로」, 세종: 국토연구원.
Lee, Y.S., Oh, M.J., and Ko, Y.H., 2022. A Study on Spatial Distribution of Housing Values and Residential Segregation by Housing Value, Sejong: Korea Research Institute for Human Settlements. -
Anselin, L., 1988. Spatial Econometrics: Methods and Models, Dordrecht: Kluwer Academic Publishers.
[https://doi.org/10.1007/978-94-015-7799-1]
-
Anselin, L., 1995. “Local Indicators of Spatial Association–LISA”, Geographical Analysis, 27(2): 93-115.
[https://doi.org/10.1111/j.1538-4632.1995.tb00338.x]
- Baltagi, B.H., 2005. Econometric analysis of panel data (3rd ed.), New Jersey: John Wiley & Sons.
-
Bowes, D.R. and Ihlanfeldt, K.R., 2001. “Identifying the Impacts of Rail Transit Stations on Residential Property Values”, Journal of Urban Economics, 50(1): 1-25.
[https://doi.org/10.1006/juec.2001.2214]
-
Buonanno, P., Montolio, D., and Raya-Vílchez, J.M., 2013. “Housing Prices and Crime Perception”, Empirical Economics, 45(1): 305-321.
[https://doi.org/10.1007/s00181-012-0624-y]
-
Ceccato, V. and Wilhelmsson, M., 2011. “The Impact of Crime on Apartment Prices: Evidence from Stockholm, Sweden”, Geografiska Annaler: Series B, Human Geography, 93(1): 81-103.
[https://doi.org/10.1111/j.1468-0467.2011.00362.x]
- Cliff, A.D. and Ord, J.K., 1973. Spatial Autocorrelation, London: Pion.
-
Elhorst, J.P., 2013. “Spatial Panel Models”, In Handbook of Regional Science, Edited by Fischer, M.M. and Nijkamp, P., Berlin, Heidelberg: Springer.
[https://doi.org/10.1007/978-3-642-23430-9_86]
-
Gibbons, S., 2004. “The Costs of Urban Property Crime”, The Economic Journal, 114(499): F441-F463.
[https://doi.org/10.1111/j.1468-0297.2004.00254.x]
-
Glaeser, E.L. and Sacerdote, B., 1996. Why Is There More Crime in Cities?, NBER Working Paper No. 5430, Cambridge: National Bureau of Economic Research.
[https://doi.org/10.3386/w5430]
- Jacobs, J., 1961. The Death and Life of Great American Cities, New York: Random House.
-
Kahneman, D. and Tversky, A., 1979. “Prospect Theory: An Analysis of Decision Under Risk”, Econometrica, 47(2): 263-291.
[https://doi.org/10.2307/1914185]
- Kwon, H. and Hwang, B.S., 2023. “Do Spatial Characteristics Affect Housing Prices in Korea?: Evidence from Bayesian Spatial Models”, Hitotsubashi Journal of Economics, 64(2): 109-124.
- Lee, K., 2022. “Innovative Spatial Analysis of Violent Crime Hot Spots in Korea: Implications for Urban Policy”, Asian Journal of Innovation and Policy, 11(3): 320-341.
-
LeSage, J.P. and Pace, R.K., 2009. Introduction to Spatial Econometrics, New York: Chapman and Hall/CRC.
[https://doi.org/10.1201/9781420064254]
-
Linden, L. and Rockoff, J.E., 2008. “Estimates of the Impact of Crime Risk on Property Values from Megan’s Laws”, American Economic Review, 98(3): 1103-1127.
[https://doi.org/10.1257/aer.98.3.1103]
-
Moran, P.A.P., 1950. “Notes on Continuous Stochastic Phenomena”, Biometrika, 37(1-2): 17-23.
[https://doi.org/10.1093/biomet/37.1-2.17]
- O’Sullivan, A., 2012. Urban Economics (8th ed.), Columbus: McGraw-Hill.
-
Oates, W.E., 1969. “The Effects of Property Taxes and Local Public Spending on Property Values: An Empirical Study of Tax Capitalization and the Tiebout Hypothesis”, Journal of Political Economy, 77(6): 957-971.
[https://doi.org/10.1086/259584]
-
Pace, R.K. and Gilley, O.W., 1997. “Using the Spatial Configuration of the Data to Improve Estimation”, The Journal of Real Estate Finance and Economics, 14(3): 333-340.
[https://doi.org/10.1023/A:1007762613901]
-
Rosen, S., 1974. “Hedonic Prices and Implicit Markets: Product Differentiation in Pure Competition”, Journal of Political Economy, 82(1): 34-55.
[https://doi.org/10.1086/260169]
-
Thaler, R., 1978. “A Note on the Value of Crime Control: Evidence from the Property Market”, Journal of Urban Economics, 5(1): 137-145.
[https://doi.org/10.1016/0094-1190(78)90042-6]
-
Tiebout, C.M., 1956. “A Pure Theory of Local Expenditures”, Journal of Political Economy, 64(5): 416-424.
[https://doi.org/10.1086/257839]
- Wooldridge, J.M., 2012. Introductory Econometrics: A Modern Approach (5th ed.), Boston: South-Western Cengage Learning.